Introducción
Dedomena Edge es la versión on-premise de la plataforma Dedomena.AI: una librería de Python que instalas en tus propios servidores para validar la calidad de tus datasets, detectar datos sensibles, anonimizarlos y entrenar sintetizadores para generar datos sintéticos, sin que tus datos salgan nunca de tu infraestructura.
Esta guía explica cómo descargar e instalar Dedomena Edge, cómo se organiza, qué necesitas para ejecutarlo y cómo usar cada una de sus funciones. Al final encontrarás un manual de referencia con todos los comandos, variables y mensajes de error.
> Tus datos no salen de tu entorno. Edge solo se conecta con Dedomena.AI para descargar el paquete y los modelos. Detectar, anonimizar, entrenar y validar se hace siempre en tu máquina, y la licencia se comprueba en local, sin conexión.
Qué incluye Dedomena Edge
Edge reúne tres librerías bajo un mismo paquete de Python, dedomena:
| Librería | Para qué sirve | Funciones principales |
|---|---|---|
Axon (dedomena.axon) | Comprobar y preparar un dataset antes de usarlo | Inspector, clean, ApplyRules, report, risk, insight |
Detección (dedomena.detection) | Encontrar qué hay de sensible en un activo y dónde está | detect, detect_in_text, detect_columns |
Nucleus (dedomena.nucleus) | Cambiar los datos: anonimizarlos, o entrenar sintetizadores para generar datos sintéticos | Anonymization, Generic, Transactional, TimeSeries, Relational, load_synthesizer |
Con ellas puedes trabajar con todos los tipos de activo:
| Activo | Detectar | Anonimizar | Entrenar sintetizadores | Validar con Axon |
|---|---|---|---|---|
| Tablas (CSV, Parquet, Excel, bases de datos) | ✔ | ✔ | ✔ | ✔ |
| Imágenes (PNG, JPG, TIFF, BMP) | ✔ | ✔ | — | — |
| Documentos (PDF, DOCX, TXT) | ✔ | ✔ | — | — |
| Audio (WAV, MP3, M4A, WMA) | ✔ | ✔ | — | — |
| Vídeo (MP4, MOV, AVI) | ✔ | — | — | — |
Los nombres de los métodos de anonimización, los tipos de elementos sensibles y los algoritmos de síntesis son los mismos que en la plataforma Dedomena.AI en la nube. Una configuración escrita para la nube funciona igual en Edge.
Arquitectura y requisitos
Cómo se organiza una instalación
Una instalación de Edge tiene tres piezas, y las tres viven en tu infraestructura:
-
La librería es el código que ejecutas desde Python. Se instala en un entorno virtual y procesa tus datos en local.
-
Los modelos son los modelos de IA que usa la detección. Se descargan aparte del código y se guardan en una carpeta local. Puedes elegir su tamaño, o no usar ninguno (ver Tamaño de los modelos).
-
La licencia es un token firmado que obtienes en la página Edge de la plataforma. La librería lo verifica en local, sin conectarse a nada.
La plataforma Dedomena.AI solo interviene para descargar el paquete, los modelos y el token desde la página Edge, y para darte los resultados cuando le subes los ficheros cifrados que producen tus flujos de trabajo: por ejemplo, los datos sintéticos generados a partir de un sintetizador que has entrenado con Edge (ver Generar datos).
Qué sale de tu máquina y qué no:
| Momento | Conexión con Dedomena.AI |
|---|---|
| Instalar con pip | Sí: se descargan el paquete y sus dependencias. |
| Instalar desde la descarga completa | No: la carpeta descargada lleva todo lo necesario. |
Descargar los modelos (dedomena-edge setup) | Sí: se descargan los modelos. |
| Detectar, anonimizar, entrenar, validar | No. Todo se ejecuta en local. |
| Generar datos sintéticos | Sí: subes el sintetizador a la plataforma Dedomena.AI y generas los datos allí, o a través de la API (ver Generar datos). |
| Comprobar la licencia | No: se verifica en local. |
| Errores y diagnóstico | No: se escriben en ficheros locales. Solo los envías tú a soporte si lo necesitas (ver Mensajes, registros y soporte). |
Módulos
El paquete se entrega por módulos: eliges los que necesitas y solo esos se instalan. Puedes elegir varios a la vez (por ejemplo, Texto + Imagen).
| Módulo | Qué incluye | Incluye además |
|---|---|---|
Tablas (tables) | Detección de columnas sensibles, anonimización de tablas, y entrenamiento y evaluación de sintetizadores | Axon |
Texto (text) | Detección y anonimización de texto libre con el modelo de lenguaje, incluidas las columnas de texto de las tablas y los métodos que necesitan ese modelo | Tablas y Axon |
Imagen (vision) | Detección y anonimización de imágenes: rostros, firmas, logotipos, huellas y texto dentro de la imagen | Axon |
Audio (audio) | Transcripción, detección de datos dichos en voz alta y anonimización de audio | Axon |
Documentos (documents) | Detección y anonimización de PDF, DOCX y TXT | Axon |
Axon (axon) | Inspección, limpieza, reglas e informe de calidad de datasets | — (va siempre incluido) |
Todos (all) | Todos los módulos anteriores | — |
Algunas cosas a tener en cuenta:
-
Axon va siempre incluido, elijas lo que elijas.
-
Texto incluye Tablas: el modelo de lenguaje se usa también sobre las columnas de texto libre de las tablas.
-
Si intentas usar algo que no está en tu paquete, la librería no falla con un error de Python: te dice que ese módulo no forma parte de tu instalación y qué módulos sí incluye.
Tamaño de los modelos: small, full o none
El paquete de código es el mismo para cualquier tamaño. El tamaño solo decide qué modelos se descargan:
| Tamaño | Qué es | Dónde se ejecuta |
|---|---|---|
| small | Modelos ligeros. Cubren las cinco modalidades con poco más de 2 GB en total. Es la opción recomendada para empezar. | CPU (la GPU es opcional) |
| full | Modelos de máxima calidad de detección. | Pensado para GPU NVIDIA (los de texto e imagen la necesitan) |
| none | Sin modelos. La detección se hace solo con patrones y validaciones (emails, DNI/NIE, IBAN, tarjetas, teléfonos…). No encuentra nombres ni empresas en texto libre. | CPU |
Modelos que se descargan según el módulo y el tamaño:
| Módulo | small | full | none |
|---|---|---|---|
| Tablas | Detección de texto ligera (0,18 GB) | Detección de texto ligera (0,18 GB) | ✔ disponible |
| Documentos | Detección de texto ligera (0,18 GB) | Detección de texto ligera (0,18 GB) | ✔ disponible |
| Texto | Detección de texto ligera (0,18 GB) | Modelo de texto completo (28,7 GB) · GPU | ✔ disponible |
| Imagen | Detección de imagen ligera, detección de firmas y detección de texto ligera (≈1,5 GB) | Modelo de imagen completo, mejora de resolución, detección de firmas y detección de texto ligera (≈36,5 GB) · GPU | ✘ no disponible |
| Audio | Transcripción ligera y detección de texto ligera (≈0,85 GB; ≈2,7 GB en su variante para GPU) | Transcripción completa y detección de texto ligera (≈0,7 GB) · funciona en CPU | ✘ no disponible |
| Todos | ≈2,2 GB | ≈65,5 GB · GPU | ✘ no disponible |
| Axon solo | No usa modelos | No usa modelos | — |
-
Con varios módulos se descarga la unión de sus modelos, sin repetir. Si va el modelo completo de un tipo, no se descarga además el ligero de ese mismo tipo.
-
Imagen y audio necesitan siempre un modelo. Sin él no hay detección de imágenes ni transcripción, así que el tamaño
noneno se ofrece con esos módulos. -
Edición generativa de imágenes (opcional). Es un modelo adicional de unos 57,7 GB que sustituye los datos de una imagen por otros con un aspecto natural, en lugar de dibujarlos encima. Solo está disponible con el módulo Imagen y hardware GPU.
Requisitos del sistema
Sistema operativo y Python
| Requisito | Valor |
|---|---|
| Sistema operativo | Linux x86_64 con glibc 2.28 o superior (RHEL/Rocky/Alma 8 o superior, Ubuntu 20.04 o superior, Debian 10 o superior). Windows y macOS aún no están soportados. |
| Python | 3.10, 3.11 o 3.12 (el mismo paquete sirve para las tres). Si tu distribución trae otra versión, instala una de estas antes. |
| Entorno | Se recomienda un entorno virtual propio para Edge (el instalador lo crea si lo necesitas). |
CPU y memoria
| Uso | Recomendación |
|---|---|
Tablas, Axon, documentos y modelos small | CPU multinúcleo (8 núcleos o más recomendados) y 32 GB de RAM (16 GB como mínimo) |
| Entrenamiento de sintetizadores con tablas grandes | Más núcleos y más RAM aceleran el entrenamiento. Una GPU es opcional y lo acelera. |
GPU (solo para el hardware gpu)
| Requisito | Valor |
|---|---|
| Tarjeta | GPU NVIDIA |
| Controlador | NVIDIA 580 o superior (CUDA 13). El instalador no lo comprueba: revísalo antes con nvidia-smi. |
Modelos full de texto e imagen | Arquitectura Ada Lovelace, Hopper o Blackwell. Memoria de vídeo: 48 GB como mínimo (con ajuste de contexto en el modelo de imagen), 80 GB recomendados y 96 GB para tener cargados a la vez los modelos de texto y de imagen. Con menos memoria, la librería los carga por turnos. |
| Edición generativa de imágenes | GPU con 80 GB de memoria o más. |
Modelos small | No necesitan GPU. Si la hay, la transcripción puede usarla (variante GPU) y los demás pueden moverse a ella (ver Registrar un modelo explícitamente). |
Antes de cargar ningún modelo puedes comprobar si caben en tu tarjeta con models.report() (ver Qué motor se va a usar).
Disco
-
Librería y dependencias: unos pocos GB (más en la variante GPU, que incluye las librerías de NVIDIA).
-
Modelos: lo que indica la tabla de Tamaño de los modelos: small, full o none. Deja margen adicional para tus datos y resultados.
Red
-
Instalación con pip: salida HTTPS a
api.dedomena.aiy a los repositorios públicos de paquetes de Python durante la instalación. -
Descarga de modelos con
dedomena-edge setup: salida HTTPS aapi.dedomena.aiy a los servidores de descarga a los que redirige. Pide a Dedomena.AI la lista de dominios si tu cortafuegos trabaja con lista blanca. -
Instalación desde la descarga completa: la máquina de destino no necesita red.
-
Uso: no hace falta red.
Qué combinación elegir
| Si quieres… | Módulos | Hardware | Tamaño |
|---|---|---|---|
| Anonimizar tablas y entrenar sintetizadores | Tablas | CPU | small (o none si tus columnas no tienen texto libre con nombres) |
| Lo anterior, más encontrar nombres y empresas en texto libre con la máxima calidad | Texto | GPU | full |
| Anonimizar DNI, pasaportes, contratos escaneados o fotos | Imagen (+ Documentos) | CPU | small |
| Lo mismo, con la máxima calidad de detección | Imagen (+ Documentos) | GPU | full |
| Anonimizar llamadas grabadas | Audio | CPU | small o full |
| Solo validar y limpiar datasets | Axon | CPU | — |
| Todo | Todos | GPU | full |
Descarga e instalación
Hay dos formas de instalar Edge. Las dos parten de la página Edge de la plataforma Dedomena.AI:
| Descarga completa | Instalación con pip | |
|---|---|---|
| Cómo | Descargas una carpeta con el paquete, todas sus dependencias, los modelos y un instalador | Instalas el paquete con pip desde el índice de Dedomena.AI y descargas los modelos con un comando |
| Red en la máquina de destino | No hace falta | Sí, durante la instalación |
| Recomendado para | Servidores sin acceso a internet, entornos regulados, instalaciones reproducibles | Máquinas con internet, actualizaciones rápidas |
> Necesitas una cuenta de la plataforma con un plan que incluya Dedomena Edge. Si tu plan no lo incluye, la descarga responde que no tienes acceso a Edge: contacta con Dedomena.AI.
La página Edge
La página tiene tres bloques, de arriba abajo:
-
Las opciones del paquete: sistema operativo, módulos, hardware y tamaño de los modelos.
-
Tu token de licencia.
-
Las dos formas de instalar: Download e Install with pip.
Elegir las opciones

-
Sistema operativo: Linux.
-
Módulos: marca uno o varios. Los que van incluidos con otro se marcan solos y quedan bloqueados (por ejemplo, al marcar Texto se marca Tablas). Axon aparece siempre marcado. All instala todo.
-
Hardware:
-
CPU: para máquinas sin GPU. Instala las librerías de cálculo en su versión ligera para CPU.
-
GPU: para máquinas con GPU NVIDIA (CUDA 13, controlador 580 o superior).
-
-
Tamaño de los modelos: small, full o none (ver Tamaño de los modelos: small, full o none). La página desactiva las combinaciones que no son posibles:
-
full con hardware CPU, si eliges Texto, Imagen o All (esos modelos necesitan GPU);
-
none, si eliges Imagen, Audio o All (necesitan un modelo).
-
-
Edición generativa de imágenes (opcional): solo aparece con Imagen y hardware GPU.
Bajo el botón de descarga, la página indica qué lleva la descarga y cuánto pesan los modelos.
Tu token de licencia
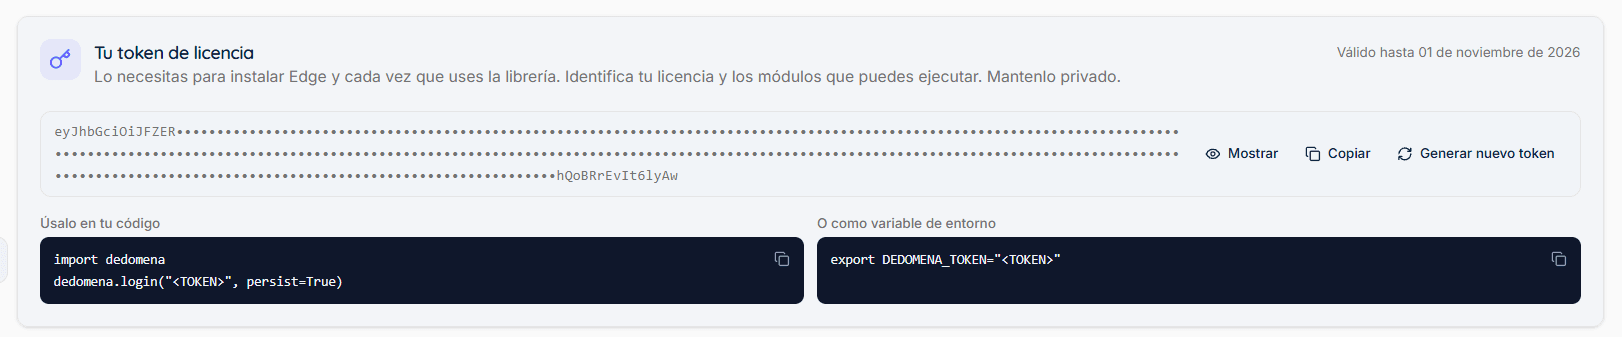
El token es tu licencia de Edge. Lo necesitas para instalar y la librería lo usa cada vez que trabajas con ella. Es personal: no lo compartas ni lo subas a un repositorio de código.
-
Show muestra el token y Copy lo copia.
-
Generate new token genera uno nuevo. Úsalo cuando el actual caduque.
-
Valid until indica la fecha de caducidad.
Los comandos de instalación de la página ya llevan tu token puesto. Más detalles en La licencia.
Opción A: descarga completa (sin internet en la máquina de destino)

-
Pulsa Download y elige una carpeta de tu ordenador.
-
En Chrome y Edge, el navegador va escribiendo los ficheros directamente en esa carpeta, comprueba cada uno y, si la descarga se corta, puedes retomarla donde se quedó.
-
En Firefox y Safari, la descarga se guarda como un único
.zip. Si se corta, hay que empezarla de nuevo. Con modelosfull(decenas de GB) te recomendamos Chrome o Edge.
-
-
Cuando termina tienes una carpeta
dedomena-edgecon este contenido:Elemento Contenido install.shEl instalador. wheels/El paquete de Edge y todas sus dependencias, para Python 3.10, 3.11 y 3.12. models/Los modelos elegidos. No existe con el tamaño none. -
Copia la carpeta a la máquina donde vas a usar Edge, por el medio que uses habitualmente (SFTP, disco, repositorio interno…). Si descargaste un
.zip, descomprímelo allí. -
Instala:
bashcd dedomena-edge bash install.sh \<TOKEN\> . ./env.sh # cada vez que abras una sesión nueva, antes de usar la librería
Qué hace install.sh:
-
Elige dónde instalar (ver la tabla siguiente) y comprueba que la versión de Python es 3.10, 3.11 o 3.12.
-
Instala Edge desde
./wheels, sin conexión a internet. -
Escribe
env.sh, que activa el entorno virtual (si lo creó) y apunta la librería a la carpeta./models(si hay modelos). -
Guarda tu licencia en la máquina, para que la librería la encuentre sin que tengas que volver a pasarla.
-
Ejecuta
dedomena-edge status, que muestra los módulos y modelos instalados.
Dónde instala:
| Comando | Dónde instala |
|---|---|
bash install.sh \<TOKEN\> | En el entorno de Python que tengas activo (venv o conda). Si no hay ninguno, crea uno nuevo en ./venv. |
bash install.sh \<TOKEN\> --venv | Siempre en un entorno nuevo: ./venv, u otra ruta con VENV=/ruta bash install.sh \<TOKEN\> --venv. |
bash install.sh \<TOKEN\> --no-venv | Siempre en el entorno activo, sin crear otro. |
Opciones adicionales:
-
PYTHON=/ruta/a/python3.11 bash install.sh \<TOKEN\>usa un intérprete concreto. -
El token también puede ir en la variable
DEDOMENA_TOKENen lugar de como argumento. -
bash install.sh --helpmuestra la ayuda.
> Atención con conda. Si tu terminal activa automáticamente el entorno base de conda, el instalador lo considera «entorno activo» e instala ahí. Usa --venv si prefieres un entorno separado.
> No muevas la carpeta después de instalar. El entorno virtual y env.sh usan rutas absolutas, y los modelos se quedan en ./models. Si necesitas otra ubicación, copia la carpeta a su sitio definitivo antes de ejecutar install.sh.
Si algo falla durante la instalación:
| Mensaje | Qué hacer |
|---|---|
ERROR: these packages are for Python 3.10 3.11 3.12 on Linux x86_64, and none was found | Instala Python 3.10, 3.11 o 3.12, o indica cuál usar: PYTHON=/ruta/a/python bash install.sh \<TOKEN\>. |
ERROR: … cannot create virtual environments: the venv module is missing. | En Debian/Ubuntu instala el paquete que indica el mensaje (por ejemplo apt install python3.11-venv), o activa un entorno que ya tengas y usa --no-venv. |
ERROR: the active environment (…) is Python X.Y; these packages are for Python 3.10 3.11 3.12. | Activa un entorno con una versión soportada, o usa --venv. |
ERROR: unknown option: … | Revisa el comando. bash install.sh --help muestra las opciones válidas. |
| Error al guardar la licencia (token caducado o incorrecto) | La librería ya está instalada. Genera un token nuevo en la página y guárdalo como se explica en Guardar la licencia en la máquina. |
Opción B: instalación con pip

-
Crea y activa un entorno virtual para Edge:
bashpython3.11 -m venv /opt/dedomena/venv . /opt/dedomena/venv/bin/activate -
Instala el paquete con el comando que muestra la página. Ya lleva tus módulos, tu hardware y tu token:
bashpip install --index-url "https://licence:\<TOKEN\>@api.dedomena.ai/edge/\<módulos\>/\<hardware\>/simple/" dedomena-edge-
\<módulos\>:all, un módulo (tables,text,vision,audio,documents,axon) o varios unidos con+(por ejemplotext+vision). El orden no importa. -
\<hardware\>:cpuogpu. -
El token va como contraseña del índice; el usuario (
licence) es indiferente.
Con hardware
gpuy modelosfull, instala además el motor de GPU que usan los modelos completos:bashpip install --index-url "https://licence:\<TOKEN\>@api.dedomena.ai/edge/\<módulos\>/gpu/simple/" "dedomena-edge[gpu]" -
-
Descarga los modelos y guarda la licencia en la máquina:
bashdedomena-edge setup --size small --token "\<TOKEN\>" # o --size full / --size nonesetuplee qué módulos tiene tu instalación y descarga los modelos que necesitan para ese tamaño. Si una descarga se corta, vuelve a ejecutar el mismo comando: continúa donde se quedó. Cada fichero se verifica al terminar, y un modelo descargado a medias nunca se usa. -
Comprueba la instalación:
bashdedomena-edge status
Opciones de dedomena-edge setup:
| Opción | Qué hace |
|---|---|
--size small|full|none | Obligatoria. El tamaño de los modelos. Con none no descarga nada, pero sí guarda la licencia. |
--token "\<TOKEN\>" | Guarda la licencia en esta máquina. |
--gpu auto|yes|no | Por defecto auto: detecta si hay GPU NVIDIA. Con GPU se descargan las variantes para GPU donde existen. Usa yes si estás descargando los modelos para otra máquina que sí tiene GPU. |
--image-edit | Descarga también el modelo de edición generativa de imágenes. |
--dir /ruta | Descarga los modelos en otra carpeta (por defecto ~/.local/share/dedomena/models). Si la usas, exporta después DEDOMENA_MODELS_DIR=/ruta. |
--type text|vision|audio | Descarga solo los modelos de ese tipo. Se puede repetir. |
--force | Vuelve a descargar aunque ya estén. |
--quiet | Sin barra de progreso. |
--workers N | Descargas en paralelo (8 por defecto). |
Mensajes de setup que te pueden aparecer:
| Mensaje | Significado |
|---|---|
These models need an NVIDIA GPU and this machine has none: … | Pediste modelos full de texto o imagen en una máquina sin GPU. Usa --size small, o --gpu yes si los descargas para otra máquina. |
These modules need a model: vision, audio. Use --size small | --size none no está disponible con Imagen ni Audio. |
No models: detection uses patterns only … | Con --size none: la licencia queda guardada y no se descarga nada. |
The full models run on the GPU engine, which is an optional extra … | Instala dedomena-edge[gpu] con el comando del paso 2. |
The model server refused the request (403): … | Tu plan no incluye Edge o tu usuario está desactivado. |
Could not reach the model server … | Revisa la conexión y el cortafuegos (ver Requisitos del sistema). |
Download kept failing … run it again to resume | Vuelve a ejecutar el mismo comando: continúa la descarga. |
Errores de pip frecuentes:
| Síntoma | Causa |
|---|---|
| pip pide usuario y contraseña, o responde 401 | El token no es válido o ha caducado. Genera uno nuevo en la página. |
| 403 | Tu plan no incluye Edge. |
| 404 | La combinación de módulos o de hardware de la URL no existe. Copia el comando tal cual desde la página. |
No matching distribution | Tu Python no es 3.10, 3.11 o 3.12, o tu sistema no es Linux x86_64. |
Comprobar la instalación
dedomena-edge status
dedomena-edge 5.6.2

Modules    : axon, small, tables, text

Models dir : /home/usuario/.local/share/dedomena/models

GPU        : no

  small-text       1.0.0
-
Modules muestra los módulos del paquete instalado.
smalles el código de los modelos ligeros, que acompaña a todo paquete con detección. -
Models dir es la carpeta donde la librería busca los modelos.
-
Debajo aparece una línea por cada modelo instalado, con su versión.
Para ver la licencia:
python -c "import dedomena; print(dedomena.auth_status())"
Y para ver qué motor de detección usará cada modalidad y si los modelos caben en tu GPU:
python -c "from dedomena.detection import models; print(models.report())"
Actualizar, ampliar o cambiar la instalación
| Quiero… | Qué hacer |
|---|---|
| Instalar una versión nueva de Edge | Descarga completa: descarga de nuevo y ejecuta install.sh en la carpeta nueva. pip: repite el comando de instalación con --upgrade. |
| Añadir módulos | El paquete es distinto para cada combinación de módulos: descarga o instala el paquete con la combinación nueva en un entorno nuevo (o con pip install --upgrade --force-reinstall en el mismo). Después ejecuta dedomena-edge setup para descargar los modelos que falten. |
| Cambiar el tamaño de los modelos | dedomena-edge setup --size full (o small). Solo descarga lo que falta. |
| Renovar la licencia | Genera un token nuevo en la página y guárdalo (ver Guardar la licencia en la máquina). No hace falta reinstalar. |
| Usar los modelos desde otra carpeta | Mueve la carpeta de modelos y exporta DEDOMENA_MODELS_DIR=/nueva/ruta. |
| Preparar los modelos para una máquina sin internet | En una máquina con internet: dedomena-edge setup --size full --gpu yes --dir /ruta/modelos. Copia esa carpeta a la máquina de destino y exporta allí DEDOMENA_MODELS_DIR. |
La licencia
La licencia es el token de la página Edge. Es un token firmado que lleva tu identificador, los permisos que tienes y su fecha de caducidad. La librería lo verifica en local, sin conectarse a nada, así que funciona en máquinas sin internet.
Guardar la licencia en la máquina
install.sh y dedomena-edge setup --token ya la guardan por ti. Si tienes que hacerlo a mano (por ejemplo, al renovarla):
import dedomena

dedomena.login("\<TOKEN\>", persist=True)   # la verifica y la guarda

dedomena.auth_status()

# Session(subject='...', scopes=('axon', 'detection', 'nucleus.anonymize', ...), expires=..., source=...)
A partir de ahí no tienes que pasar el token a ninguna función: todas lo encuentran solas.
-
persist=Trueguarda el token en~/.config/dedomena/token, con permisos solo para tu usuario. Sinpersist=True,login()vale para la sesión de Python actual y no escribe nada en disco. -
dedomena.logout()cierra la sesión.
Dónde busca la librería el token
En este orden:
-
El argumento
token=de la función que llamas. -
La sesión abierta con
dedomena.login(...). -
La variable de entorno
DEDOMENA_TOKEN. -
El fichero de licencia guardado (
~/.config/dedomena/token).
Contenedores, CI y gestores de secretos. Si tu política no permite guardar credenciales en disco, pasa el token por la variable DEDOMENA_TOKEN y define DEDOMENA_NO_PERSIST=1: la librería no escribirá nada en el directorio del usuario. Con DEDOMENA_CONFIG_DIR puedes cambiar la carpeta del fichero de licencia.
Permisos
El token indica qué puedes hacer:
| Permiso | Permite |
|---|---|
axon | Validar y preparar datasets |
detection | Usar la detección directamente y descargar modelos |
nucleus.anonymize | Anonimizar y revertir anonimizaciones |
nucleus.synthesis | Entrenar sintetizadores |
Si intentas algo que tu licencia no cubre, la librería lo dice con el nombre de la actividad: Your Dedomena licence does not cover training a synthesizer. It covers: …. En ese caso, solicita a Dedomena.AI el permiso correspondiente.
Caducidad y renovación
-
La fecha de caducidad aparece en la página (Valid until) y en
dedomena.auth_status(). -
15 días antes de caducar, la librería avisa:
Warning: Your Dedomena token expires on … (N day(s) left). -
Cuando caduca, las funciones dejan de ejecutarse con el mensaje
Your Dedomena token expired on …. Genera un token nuevo en la página y guárdalo condedomena.login("\<TOKEN_NUEVO\>", persist=True). No hace falta reinstalar nada. -
Atrasar el reloj del sistema no extiende la licencia.
Primeros pasos con la librería
Antes de empezar
Si instalaste con la descarga completa, carga el entorno en cada sesión nueva:
. /ruta/a/dedomena-edge/env.sh
Después:
import dedomena

print(dedomena.__version__)

from dedomena.nucleus import anonymize            # anonimización

from dedomena.nucleus import Auto, Generic        # sintetizadores

from dedomena.detection import detect             # detección

from dedomena.axon import Inspector, clean        # calidad de datos
import dedomena no carga nada pesado: cada librería se carga la primera vez que la usas.
Fuentes de datos
Todas las funciones que reciben datos aceptan las mismas fuentes:
| Fuente | Cómo se indica |
|---|---|
| Fichero | La ruta: "datos/clientes.csv". El tipo se deduce de la extensión. |
| CSV | .csv. El separador y la codificación se detectan solos. |
| Parquet | .parquet |
| Excel | .xlsx |
| Matriz dispersa | .mtx, o source_format="MTX" |
| DataFrame de pandas | El propio DataFrame. |
| Base de datos | La URL de conexión, con source_format="DATABASE" y query= (un nombre de tabla o una consulta SQL). |
| Imagen, documento, audio, vídeo | La ruta del fichero (ver los formatos en Qué incluye Dedomena Edge). |
Bases de datos. Se admiten PostgreSQL, MySQL/MariaDB, SQL Server, Oracle, SQLite e IBM Db2:
anonymize(

    "postgresql://usuario:contraseña@servidor:5432/crm",

    source_format="DATABASE",

    query="SELECT * FROM clientes WHERE alta \>= '2026-01-01'",

    config="auto",

    output="salida/clientes_anonimizados.parquet",

    output_format="PARQUET",

)
Si query es una sola palabra, se interpreta como nombre de tabla (SELECT * FROM "clientes").
IBM Db2. Descarga el controlador JDBC de IBM (db2jcc4.jar) y cópialo en la carpeta DB2Driver dentro del paquete instalado. Necesitas también un entorno de ejecución de Java en la máquina:
python -c "import dedomena, os; print(os.path.join(os.path.dirname(dedomena.__file__), 'DB2Driver'))"
La URL tiene esta forma:
jdbc:db2://\<host\>:\<puerto\>/\<base_de_datos\>:sslConnection=true;user=\<usuario\>;password=\<contraseña\>;
Controladores JDBC de Db2: <https://www.ibm.com/support/pages/db2-jdbc-driver-versions-and-downloads\>
El activo (Asset)
Casi todas las funciones devuelven un activo (dedomena.core.Asset): un objeto que lleva los datos y lo que se sabe de ellos.
| Atributo | Qué contiene |
|---|---|
content | Los datos: un DataFrame, o la ruta del fichero escrito. |
kind | table, image, document, audio o video. |
sensitive_elements | Los elementos sensibles encontrados: [\{'value', 'type', …ubicación\}]. |
schema, quality, info | Lo que Axon ha averiguado del dataset. |
lineage | El historial de operaciones aplicadas (inspección, limpieza, anonimización, síntesis…). |
ai_generated | Si alguna operación generó contenido nuevo (ver Marca de contenido generado). |
Puedes pasar un activo de una función a otra: Axon prepara, la detección encuentra, Nucleus anonimiza o sintetiza, y el historial se conserva. Para guardarlo:
activo.save("salida/", data_format="CSV") # salida/data.csv + salida/meta.json
Mensajes, registros y soporte
La librería no muestra trazas de error de Python. Cuando algo falla, verás una sola línea:
Dedomena error [3f9a1c02]: Failed to train the synthesizer.

Details were written to /ruta/logHistory.log
| Fichero | Qué contiene | Para quién |
|---|---|---|
logHistory.log | El registro de la ejecución: qué se hizo y una línea por cada error, con su identificador. Se escribe en la carpeta de resultados o en la carpeta actual. | Para ti |
dedomena-support.enc | El diagnóstico técnico de los errores, cifrado para que solo pueda leerlo el soporte de Dedomena.AI. No contiene tus datos: los valores se eliminan antes de cifrar. | Para enviarlo a soporte si lo necesitas |
DEDOMENA_LOG_FILE=/ruta/mi_log.logcambia la ubicación del registro. Es útil con varios trabajos en paralelo.
Si necesitas ayuda, envía a soporte el identificador del error ([3f9a1c02]), logHistory.log y, si existe, dedomena-support.enc.
Detección de elementos sensibles
La detección encuentra los datos sensibles de un activo y dice dónde están. La anonimización la ejecuta sola cuando hace falta, pero también puedes usarla directamente: para auditar qué datos tienes, revisar lo encontrado antes de anonimizar o alimentar tus propios procesos.
detect()
from dedomena.detection import detect

detect("documentos/dni.png")          # imagen

detect("documentos/contrato.pdf")     # PDF, DOCX o TXT

detect("llamadas/atencion.mp3")       # audio

detect(dataframe)                     # tabla: qué columna es de qué tipo

detect("Mi DNI es 12345678Z")         # texto libre
Devuelve una lista de elementos con la misma forma para todas las modalidades: el valor, su tipo y dónde está.
| Activo | Ubicación | Ejemplo |
|---|---|---|
| Texto | start, end (posición de los caracteres) | \{'value': '12345678Z', 'type': 'dni', 'start': 10, 'end': 19\} |
| Tabla | column | \{'value': None, 'type': 'email', 'column': 'correo'\} |
| Imagen | box (píxeles: x0, y0, x1, y1) | \{'value': '', 'type': 'face', 'box': (120, 80, 260, 240)\} |
page y box | \{'value': 'Ana García', 'type': 'name', 'page': 0, 'box': (…)\} | |
| DOCX | paragraph | |
| Audio | start, end (segundos) | \{'value': '612 345 678', 'type': 'phone_number', 'start': 12.4, 'end': 15.1\} |
| Vídeo | start, end y box |
Requiere el permiso detection. Si tu paquete no incluye la modalidad del activo, la función te lo dice con el mensaje Detection for '…' is not part of this build.
Cómo se detecta
Edge combina varias capas, y siempre trabajan juntas:
-
Patrones y validaciones (siempre activos): emails, teléfonos, DNI/NIE/CIF con su letra de control, IBAN con su dígito de control, tarjetas con su algoritmo de verificación, matrículas, direcciones IP… Ganan cualquier solapamiento: un número que supera su validación es un hecho.
-
Modelos de IA (según el tamaño instalado): encuentran lo que ningún patrón alcanza, como nombres, empresas, direcciones escritas libremente, categorías especiales de datos (salud, religión, afiliación sindical…), rostros, firmas, logotipos y huellas.
-
Lectura de texto en imágenes (en Imagen y en PDF escaneados): el texto de la imagen se lee y se analiza como cualquier otro texto, en español, inglés, euskera, catalán y gallego.
-
Transcripción (en Audio): el audio se transcribe con marcas de tiempo por palabra, y la detección se aplica a la transcripción. Se recuperan también números dictados en palabras («seis, uno, dos…») cuando superan su validación.
La librería elige sola el mejor motor que tiene instalado para cada modalidad (ver Modelos: automáticos, registrados y propios). La forma del resultado no cambia con el motor, solo la cobertura.
> Sin modelo de imagen no hay detección de imágenes. Si tu paquete incluye Imagen y no has descargado ningún modelo, la primera imagen falla con un mensaje que indica el comando: dedomena-edge setup --size small. Así nunca se entrega una imagen revisada solo a medias.
Tipos de elementos sensibles
Cada elemento tiene un tipo: el código que usas en la configuración de la anonimización. Los tipos son los mismos que en la plataforma en la nube.
| Categoría | Códigos |
|---|---|
| Identidad | name, first_name, last_name, birthdate, age, gender, nationality, dni, nie, nif, vat, ssn, passport_number, document_support_number, health_card |
| Identidad (visual) | face, signature, fingerprint |
| Dirección y ubicación | address, street_address, street_name, city, postcode, country, country_code, coordinate, latitude, longitude |
| Red | email, company_email, url, domain_name, hostname, ipv4, ipv4_private, ipv4_public, ipv6, mac_address |
| Telecomunicaciones | phone_number, msisdn, country_calling_code |
| Bancario y financiero | iban, bban, aba, swift, swift8, swift11, bank_country, credit_card_number, credit_card_full, credit_card_expire, credit_card_provider, credit_card_security_code |
| Empresa y marca | company, logo (visual) |
| Vehículo | license_plate, vin |
| Códigos de barras | ean, ean8, ean13, localized_ean, localized_ean8, localized_ean13 |
| Credenciales | password, pin, api_key, access_token, refresh_token, private_key, secret |
| Categorías especiales y salud | religion, ethnicity, sexual_orientation, political_opinion, trade_union, medical_condition, mental_health, biometric_data, genetic_data |
Para limitar la detección de texto a unos tipos concretos:
from dedomena.detection import detect_in_text

detect_in_text("Llama al 612 345 678 o escribe a ana@ejemplo.com", types=["phone_number"])
detect_in_text(texto, certain_only=True) devuelve solo los valores que han superado una validación (letra de control, dígito de control…).
Tablas: qué columna es de qué tipo
from dedomena.detection import detect_columns

detect_columns(dataframe)

# [\{'value': None, 'type': 'email', 'column': 'correo'\}, \{'value': None, 'type': 'dni', 'column': 'documento'\}, ...]
Necesita el módulo Tablas. Las columnas se clasifican por su nombre y por una muestra de sus valores.
Revisar y reutilizar una detección
Puedes detectar, revisar el resultado (o dárselo a revisar a una persona) y anonimizar después exactamente lo revisado, sin volver a detectar:
from dedomena.core import Asset

from dedomena.detection import detect

from dedomena.nucleus import anonymize

activo = Asset("documentos/dni.png")

activo.sensitive_elements = detect(activo)

activo.save_elements("revision/dni.elements.json")       # JSON para revisar o editar

# ... revisión ...

revisado = Asset.load_elements("revision/dni.elements.json")

anonymize(revisado, config="auto", output="salida/dni_anonimizado.png")
Un activo con sus elementos asignados se considera ya revisado: la anonimización no vuelve a detectar y no pisa la revisión.
Audio en lote
Para procesar muchos audios, usa las funciones de lote. Cada audio escribe su propio resultado, así que una tirada larga puede retomarse:
from dedomena.detection import audio

rutas = audio.discover("/datos/llamadas", recursive=True)

resultados = audio.detect_many(

    rutas,

    output_dir="/datos/salida/detecciones",   # un \<audio\>.detection.json por fichero

    types=\{"iban", "credit_card_number", "credit_card_security_code", "credit_card_expire"\},

    resume=True,                              # salta los ya procesados

    return_transcript=True,

    workers=1,

)

audio.write_summary(resultados, "/datos/salida/detecciones")
Para un solo fichero:
alineados, sin_alinear, transcripcion = audio.transcribe_and_detect(

    "llamada.mp3", language="es", return_transcript=True)
-
alineadosson los elementos con su intervalo de tiempo. -
sin_alinearson los valores detectados que no se pudieron situar en el tiempo. Se devuelven aparte para que nunca se pierdan en silencio. -
Si guardas la transcripción y sus marcas de tiempo, puedes repetir la detección con otros tipos sin volver a transcribir:
audio.detect_in_transcript(transcripcion, palabras, types=…). -
device="auto"(por defecto) usa la GPU si está disponible para la transcripción ligera.device="cpu"la fuerza a CPU.
Anonimización
La anonimización modifica las partes sensibles de tus datos reales y deja todo lo demás exactamente como estaba. El resultado es un nuevo fichero anonimizado. Requiere el permiso nucleus.anonymize; la detección que hace por dentro no necesita el permiso detection.
Primer ejemplo
import dedomena

from dedomena.nucleus import anonymize

resultado = anonymize(

    "datos/clientes.csv",

    config="auto",                                   # detecta y aplica el método por defecto a cada elemento

    output="salida/clientes_anonimizados.csv",

    output_dir="resultados",                         # mapeo, registro e informe de conformidad

)

print(resultado.content)    # 'salida/clientes_anonimizados.csv'
anonymize() funciona igual con una tabla, una imagen, un documento o un audio: el tipo se deduce de la fuente.
Parámetros de anonymize():
| Parámetro | Por defecto | Descripción |
|---|---|---|
source | — | Ruta, DataFrame, URL de base de datos o Asset. |
config | "auto" | Qué método aplicar a cada columna o elemento (ver La configuración). |
output | \<nombre\>_anonymized.\<ext\> en la carpeta actual | Dónde escribir el resultado. Te recomendamos indicarlo siempre. |
output_format | según la extensión | Para tablas: CSV, PARQUET, EXCEL o DATAFRAME (devuelve el resultado en memoria, en resultado.content, sin escribir fichero). |
output_dir | "results" | Carpeta del mapeo de reversión, el registro de la ejecución y el informe de conformidad. |
source_format, query | — | Para bases de datos ("DATABASE" y la consulta) o para forzar el formato de un fichero. |
country | "Spain" | País de los datos (en inglés): decide el formato de los valores generados (nombres, DNI, IBAN, teléfonos…). |
sensitive_elements | — | Elementos ya detectados (por ti o en una revisión). Si se pasan, no se vuelve a detectar. Para tablas también admite \{columna: tipo\}. |
image_options | — | Opciones de imagen (ver Imágenes). |
audio_options | — | Opciones de audio (ver Audio). |
noise_level | 0.05 | Ruido por defecto para perturb. |
seeds | — | Semillas para que los valores generados sean reproducibles. |
verbose | True | Mostrar el progreso. |
Devuelve un Asset cuyo content es la ruta escrita (o el DataFrame, con output_format="DATAFRAME") y cuyo historial registra la anonimización.
La configuración
La configuración dice qué hacer con cada columna (en tablas) o con cada tipo de elemento (en imágenes, documentos y audio).
Modo automático. config="auto" detecta los elementos sensibles y aplica a cada uno el método por defecto de su tipo (ver Qué métodos admite cada tipo).
Forma corta. El nombre del método:
config = \{

    "email":   "mask",

    "salario": "perturb",

    "notas":   "drop",

\}
Forma extendida. Un diccionario con el método y, si lo admite, su parámetro (param):
config = \{

    "dni":        \{"method": "pseudonym", "param": r"CLI-\d\{6\}"\},

    "nombre":     \{"method": "simulation", "param": "name"\},

    "email":      \{"method": "simulation", "param": "email", "derive_from": "nombre"\},

    "cp":         \{"method": "mask", "param": 3\},

    "fecha_alta": \{"method": "date_shift", "param": "id_cliente"\},

    "codigo":     \{"method": "mask", "type": "string"\},

\}
| Clave | Para qué |
|---|---|
method | El método (ver Métodos de anonimización). |
param | El único parámetro del método, si lo tiene. |
type | Fuerza el tipo de la columna: string, categorical, numeric, integer, float, boolean, datetime o text. Úsalo, por ejemplo, para que un código postal 08001 no pierda el cero inicial. |
derive_from | Genera el valor a partir de otra columna ya anonimizada. Por ejemplo, el email simulado se construye con el nombre simulado. |
references | "tabla.columna": la columna es una clave ajena y reutiliza el valor que recibió esa entidad en la otra tabla (ver Entregas de varios activos). |
group_variants | Activo por defecto: las variantes de una misma entidad («Ana García» y «Ana») reciben un reemplazo coherente. |
-
En tablas, las claves son los nombres de las columnas. Las columnas que no aparecen en la configuración no se tocan.
-
En imágenes, documentos, audio y vídeo, las claves son los códigos de los tipos de elementos (ver Tipos de elementos sensibles). Se aceptan con mayúsculas, espacios o guiones bajos indistintamente.
-
Los nombres de método admiten sinónimos:
simulateessimulation,tokenizeescoding,blackoutesredact,muteessilence, etc. Los nombres que usa la plataforma en la nube también se aceptan.
Métodos de anonimización
| Método | Qué hace | Parámetro (param) | Reversible |
|---|---|---|---|
mask | Oculta caracteres del valor. | Modo: asterisks (por defecto, conserva el primer y el último carácter), opaque (lo oculta todo y conserva separadores) o un número n (conserva los n primeros caracteres: 28001 con 3 → 280**) | Sí |
hash | Sustituye el valor por su huella SHA-256. El mismo valor da siempre la misma huella. | — | No |
pseudonym | Sustituye cada valor por un seudónimo único y estable. | Patrón opcional, por ejemplo EMP-\d\{6\} | Sí |
simulation | Sustituye el valor por otro verosímil del mismo tipo (un nombre por otro nombre, un IBAN por otro IBAN válido), con el formato del país de los datos. | Tipo de valor a generar: cualquier código de Tipos de elementos sensibles (por defecto name) | Sí |
coding | En texto libre, sustituye cada dato sensible por una etiqueta (\{\{ Name_1 \}\}) o por un valor inventado. | Modo: tokens (por defecto, etiquetas) o invented (valores inventados) | Sí |
text_regenerate | Reescribe un texto libre completo con el modelo de lenguaje, sin datos personales, conservando el idioma, el tono y el formato de la columna. | — | Sí |
shuffle | Baraja los valores de la columna entre las filas. | — | No |
generalize | Agrupa valores en intervalos (1980-1990). En categorías, agrupa las poco frecuentes en Others. | Tamaño del intervalo (por defecto 10) | Sí |
perturb | Añade ruido aleatorio a valores numéricos o fechas. | Nivel de ruido entre 0 y 1 (por defecto 0,05) | No |
date_shift | Desplaza las fechas un intervalo aleatorio, el mismo para todas las fechas de una entidad. | Columna de la entidad (por ejemplo id_cliente) para mantener el mismo desplazamiento en todas sus filas y tablas | Sí |
drop | Elimina la columna del resultado. | — | No |
blur | Difumina la región (rostro, firma, logotipo, huella). La intensidad se ajusta al tamaño de la región. | — | No |
pixelate | Pixela la región. | Tamaño del bloque, de 4 a 64 (por defecto, según el tamaño de la región) | No |
redact | Cubre la región con un rectángulo opaco. | — | No |
beep | Sustituye el tramo de audio por un pitido. | — | No |
silence | Silencia el tramo de audio, sin cambiar la duración. | — | No |
remove | Corta el tramo de audio. | — | No |
Métodos que necesitan el modelo de lenguaje. text_regenerate necesita el módulo Texto con un modelo registrado (ver Registrar un modelo explícitamente). Sin él, la anonimización se detiene con un error en lugar de entregar la columna vacía o sin tocar. Tampoco se puede usar en columnas que no son texto libre: en una columna de URLs o de códigos, usa simulation o coding.
Qué métodos admite cada tipo
El método debe ser válido para el tipo de la columna o del elemento. El primero de cada lista es el que aplica config="auto".
| Tipo | Métodos (el primero es el de por defecto) |
|---|---|
| Elemento de texto (en imágenes, documentos y texto libre) | mask, coding, simulation, pseudonym, hash |
| Elemento visual (rostro, firma, logotipo, huella) | pixelate, blur, redact |
| Elemento de audio | beep, silence, remove |
| Columna de texto | mask, simulation, pseudonym, coding, hash, shuffle, drop, generalize, text_regenerate, date_shift |
| Columna categórica | mask, simulation, pseudonym, shuffle, hash, coding, drop, generalize, text_regenerate |
| Columna numérica | perturb, shuffle, mask, hash, drop |
| Columna booleana | pseudonym, shuffle, mask, simulation, hash, drop |
| Columna de fecha | date_shift, mask, shuffle, simulation, drop, perturb |
date_shift se acepta también en columnas de texto porque las fechas leídas de un CSV suelen llegar como texto.
Tablas
from dedomena.nucleus import anonymize

anonymize(

    "datos/empleados.parquet",

    config=\{

        "dni":         \{"method": "pseudonym", "param": r"EMP-\d\{6\}"\},

        "nombre":      \{"method": "simulation", "param": "name"\},

        "email":       \{"method": "simulation", "param": "email", "derive_from": "nombre"\},

        "telefono":    "mask",

        "salario":     \{"method": "perturb", "param": 0.1\},

        "nacimiento":  \{"method": "generalize", "param": 10\},

        "observaciones": \{"method": "coding", "param": "tokens"\},

    \},

    output="salida/empleados_anonimizados.parquet",

    output_format="PARQUET",

    output_dir="resultados",

    country="Spain",

)
-
Las tablas se anonimizan en CPU. Solo necesitan un modelo si usas
text_regenerate, o si quieres quecodingencuentre nombres y empresas dentro del texto libre (con el modelo ligero o el completo). -
Para recibir el resultado en memoria:
output_format="DATAFRAME"y lo tienes enresultado.content. -
Si no indicas
output, el fichero se escribe en la carpeta actual como\<nombre\>_anonymized.\<ext\>.
Imágenes
anonymize(

    "documentos/dni.png",

    config=\{

        "face":      "blur",

        "signature": "redact",

        "name":      \{"method": "simulation", "param": "name"\},

        "dni":       "mask",

        "birthdate": "mask",

    \},

    output="salida/dni_anonimizado.png",

)
-
Elementos visuales (rostro, firma, logotipo, huella): se oculta toda la región, incluido el texto que haya encima.
-
Texto dentro de la imagen: el valor original se borra y se dibuja el nuevo valor ajustado a su espacio, con colores tomados de la propia imagen.
-
Zona MRZ de pasaportes y documentos de identidad: se sustituye por una MRZ sintética válida (con sus dígitos de control), coherente con los datos ya anonimizados del documento. Si no se puede reconstruir con seguridad, se pixela.
-
Edición generativa (opcional, requiere su modelo y GPU): si está instalada, los textos se sustituyen con un aspecto natural en lugar de dibujados encima. Si no está instalada, se usa el método de dibujo, siempre predecible.
-
Si un elemento configurado no tiene ubicación, la anonimización falla en lugar de entregar una imagen que parece anonimizada y no lo está.
Opciones de imagen (image_options):
| Opción | Por defecto | Descripción |
|---|---|---|
blur_radius | según el tamaño | Intensidad fija del difuminado. |
pixelate_block | según el tamaño | Tamaño fijo del bloque de pixelado. |
fill_color | (0, 0, 0) | Color de redact. |
text_color, background_color | tomados de la imagen | Colores del texto redibujado. |
font_path | automática | Fuente para el texto redibujado. |
padding | 2 | Margen en píxeles alrededor de cada región. |
mrz_synth | True | Sustituir la zona MRZ por una sintética válida. |
generative_replace | True | Intentar la edición generativa si su modelo está instalado. Con False se usa siempre el dibujo. |
Documentos
anonymize(

    "documentos/contrato.pdf",

    config=\{"name": "pseudonym", "address": "mask", "iban": "hash", "signature": "redact"\},

    output="salida/contrato_anonimizado.pdf",

)
-
PDF: el texto sensible se elimina del documento, no solo se tapa (no se puede recuperar seleccionándolo ni copiándolo), y el reemplazo se escribe con la fuente, el tamaño y el color originales. Se anonimizan también los campos de formulario, las imágenes incrustadas y las regiones visuales (firmas, rostros, logotipos).
-
DOCX: se recorren el cuerpo, las tablas, los encabezados y los pies de página. Un párrafo modificado puede perder el formato de caracteres que tuviera dentro.
-
TXT: sustitución directa del texto.
Audio
anonymize(

    "llamadas/atencion_cliente.mp3",

    config=\{"name": "beep", "phone_number": "beep", "iban": "silence", "address": "beep"\},

    output="salida/atencion_cliente_anonimizada.mp3",

    audio_options=\{"language": "es"\},

)
Opciones de audio (audio_options):
| Opción | Por defecto | Descripción |
|---|---|---|
language | detección automática | Idioma de la grabación ("es", "en", "fr"…). Indicarlo mejora la transcripción. |
beep_frequency | 1000 | Frecuencia del pitido, en Hz. |
beep_gain_db | -3 | Volumen del pitido, relativo al volumen medio de la grabación. |
padding_ms | 50 | Margen añadido a cada lado del tramo anonimizado, en milisegundos. |
fail_on_unaligned | False | Si es True, la anonimización falla cuando un valor detectado no se puede situar en el tiempo. Si es False, se registra en el informe de conformidad. |
-
Si dos tramos se solapan, se aplica el método más destructivo (
remove>silence>beep). -
El resultado conserva el formato de entrada.
Entregas de varios activos
Cuando anonimizas varios activos relacionados (varias tablas de un mismo sistema, o una tabla y los documentos de esos mismos clientes), usa la clase Anonymization. Garantiza que:
-
la misma persona recibe el mismo reemplazo en todos los activos;
-
las fechas de una misma entidad se desplazan igual en todas las tablas;
-
las claves ajenas (
references) siguen coincidiendo después de anonimizar.
from dedomena.nucleus import Anonymization

politica = \{

    "id_cliente": \{"method": "pseudonym", "param": r"C-\d\{6\}"\},

    "nombre":     \{"method": "simulation", "param": "name"\},

    "email":      \{"method": "simulation", "param": "email", "derive_from": "nombre"\},

    "fecha":      \{"method": "date_shift", "param": "id_cliente"\},

\}

tablas = [

    \{"name": "pedidos",  "data": "datos/pedidos.csv",

     "config": \{**politica, "id_cliente": \{"method": "pseudonym", "references": "clientes.id_cliente"\}\}\},

    \{"name": "clientes", "data": "datos/clientes.csv", "config": politica\},

]

anon = Anonymization(config=politica, output_dir="entrega_octubre", country="Spain")

for tabla in anon.ordered(tablas):          # primero las tablas referenciadas

    anon.run(tabla["data"], name=tabla["name"], config=tabla["config"],

             output=f"entrega_octubre/\{tabla['name']\}.csv")

anon.conformance()                          # informe de conformidad en PDF y JSON

print(anon.findings)                        # lo que haya quedado sin tratar
-
ordered()ordena las tablas para que una tabla referenciada se anonimice antes que las que la referencian. -
run()acepta las mismas fuentes queanonymize(), másname(el nombre de la tabla en la entrega, al que apuntan lasreferences) yconfig(para sobrescribir la política en ese activo).
Qué ficheros se generan
| Fichero | Dónde | Qué contiene |
|---|---|---|
| El activo anonimizado | output | Tu fichero, anonimizado. |
metadata_anonymization_mapping.json | output_dir | El mapeo \{original: anonimizado\} de los métodos reversibles. Es el único fichero que contiene los valores originales: guárdalo protegido. |
metadata_anonymization_run.json | output_dir | Qué activos se procesaron, con qué política y qué se trató en cada uno. |
conformance.json | output_dir | El registro de conformidad, actualizado tras cada activo. |
conformance.pdf | output_dir | El informe de conformidad, al llamar a Anonymization.conformance(). |
\<fichero\>-metadata.json | junto al activo | La marca de contenido generado (ver Marca de contenido generado), solo si se aplicó un método que genera valores. |
logHistory.log | output_dir | El registro de la ejecución. |
El informe de conformidad describe qué se detectó, qué se trató y con qué método, qué valores cambiaron, qué entidades se comparten entre activos y de qué protege (y de qué no) cada tratamiento. Si algo quedó sin tratar (una columna configurada que no existe, un valor de audio que no se pudo situar en el tiempo…), aparece en el informe y además se muestra en pantalla al terminar ese activo, aunque verbose=False.
Marca de contenido generado
Cuando un método escribe valores nuevos (simulation, text_regenerate o coding en modo invented) y ha tratado al menos un elemento, Edge marca el resultado como contenido generado por IA, tal como exige el artículo 50 del Reglamento Europeo de IA:
-
el historial del activo lo indica (
resultado.ai_generatedesTrue); -
junto al fichero se escribe
\<fichero\>-metadata.jsoncon la información de procedencia.
Los métodos que ocultan, eliminan o transforman lo que había (mask, hash, pseudonym, blur, pixelate, redact, beep, drop, perturb, shuffle, generalize, date_shift) no marcan el resultado. Los datos sintéticos se marcan siempre.
Revertir y entregas incrementales
Los métodos reversibles (mask, pseudonym, simulation, generalize, coding, date_shift, text_regenerate) guardan su mapeo en output_dir. Con él, una persona autorizada puede revertir una tabla anonimizada:
from dedomena.nucleus import deanonymize

original = deanonymize("salida/clientes_anonimizados.csv",

                       mapping_dir="resultados",

                       output="revertido/clientes.csv")
hash, shuffle, perturb, drop y los métodos visuales y de audio no se pueden revertir. La reversión se aplica a tablas.
Entregas incrementales. Para anonimizar los datos del mes siguiente con exactamente los mismos reemplazos que la entrega anterior (la misma persona recibe el mismo seudónimo, sus fechas se desplazan igual), carga la entrega anterior:
from dedomena.nucleus import Anonymization

anon = Anonymization.load("entrega_octubre")

anon.run("datos/clientes_noviembre.csv", name="clientes",

         output="entrega_noviembre/clientes.csv")
Datos sintéticos
Un sintetizador aprende las propiedades estadísticas de tus datos reales, de modo que a partir de él se pueden generar datos sintéticos nuevos sin copiar los registros originales. El flujo es siempre el mismo:
-
Entrenar el sintetizador con tus datos, en tu máquina (
train). -
Evaluar su calidad, su privacidad y su utilidad (
evaluate). -
Guardarlo en un fichero (
save). -
Subir el sintetizador a la plataforma Dedomena.AI.
-
Generar los datos sintéticos desde la plataforma, o a través de la API.
Entrenar requiere el módulo Tablas y el permiso nucleus.synthesis. Los datos sintéticos se generan en la plataforma Dedomena.AI, a partir del sintetizador que subes (ver Generar datos).
Elegir el algoritmo
| Algoritmo | Clase | Para qué datos |
|---|---|---|
| Genérico | Generic | Una tabla en la que cada fila es independiente (clientes, pólizas, pacientes…). |
| Transaccional | Transactional | Movimientos de una entidad a lo largo del tiempo, con fecha, importe y concepto (movimientos bancarios, compras…). |
| Series temporales | TimeSeries | Medidas periódicas de varias entidades (lecturas de contadores, sensores…). |
| Relacional | Relational | Varias tablas relacionadas por claves (clientes → pedidos → líneas). |
| Automático | Auto | Lee los datos y elige entre Generic, Transactional y Relational. |
from dedomena.nucleus import Auto, choose_algorithm

choose_algorithm("datos/ventas.csv")          # ('transactional', 'motivo…'), sin entrenar nada

modelo = Auto(epochs=150)

modelo.train("datos/ventas.csv")

print(modelo.algorithm, modelo.reason)
Auto nunca elige TimeSeries: si tus datos son series temporales, usa esa clase directamente.
Ejemplo completo (Generic)
import dedomena

from dedomena.nucleus import Generic

# 1. Configurar

modelo = Generic(

    synthesizer_name="clientes_v1",

    synthesizer_description="Clientes particulares 2026",

    epochs=200,

    batch_size=256,

    configuration=\{

        "categorical_columns": ["provincia", "segmento"],

        "integer_columns": ["edad"],

        "float_columns": ["ingresos"],

        "date_columns": \{"fecha_alta": "%Y-%m-%d"\},

        "id_columns": \{"id_cliente": r"CLI-\d\{6\}"\},

        "target": "segmento",

    \},

    sensitive=\{"nombre": "name", "email": "email", "dni": "dni"\},

    constraints=["edad\>=18", "ingresos\>=0"],

)

# 2. Entrenar

modelo.train("datos/clientes.csv")

# 3. Evaluar (escribe informe/report.pdf e informe/evaluation.json)

privacidad, calidad, utilidad = modelo.evaluate(output_dir="informe")

# 4. Guardar (escribe sintetizadores/synthesizer.zip, con el informe dentro)

modelo.save("sintetizadores")

# 5. Sube sintetizadores/synthesizer.zip a la plataforma Dedomena.AI y genera allí los datos
Opciones comunes
Estas opciones se pasan al crear Generic, Transactional, TimeSeries o Auto:
| Opción | Por defecto | Descripción |
|---|---|---|
epochs | 150 | Pasadas de entrenamiento. Se recomiendan entre 150 y 300. También se puede indicar en train(epochs=…). |
batch_size | 128 | Tamaño de lote (128, 256, 512…). |
configuration | \{\} | Los tipos de las columnas (ver la tabla siguiente). |
sensitive | \{\} | \{columna: tipo\}. Columnas sensibles que, en los datos generados, se rellenan con valores ficticios verosímiles del tipo indicado (name, first_name, last_name, email, phone_number, address, city, iban, credit_card_number, company, dni, nie, nif, cif, ssn, birthdate, gender, nationality, health_card, passport_number…). |
datasets_country | "Spain" | País de los datos (en inglés): decide el formato de los valores ficticios. |
constraints | [] | Reglas que los datos generados deben cumplir siempre (ver Restricciones). |
amplify | "default" | "default" genera registros nuevos. "quality" maximiza la fidelidad partiendo de los registros reales ligeramente modificados: ofrece mucha menos privacidad y requiere al menos 150 pasadas. Úsalo solo si la privacidad no es el objetivo. |
impute | True | Rellena los valores ausentes al entrenar, y los datos generados no tienen vacíos. Con False, los vacíos se conservan. |
max_categories | — | Máximo de valores distintos que conserva una columna categórica; los menos frecuentes se agrupan en Others - DM. |
min_freq_categories | — | Frecuencia mínima para conservar un valor; los menos frecuentes se agrupan en Others - DM. |
num_cat | — | Número de valores numéricos más frecuentes que se tratan como categorías (mejora precios habituales, importes redondos, ceros…). |
coordinate_columns | [] | Pares de latitud y longitud: [\{"latitude": "lat", "longitude": "lon"\}]. |
drop_primary | False | Excluye del modelo las columnas categóricas que son prácticamente una clave (99 % de valores distintos). |
cuda | True | Entrena en GPU si hay una disponible; si no, en CPU. cuda=False fuerza la CPU. |
synthesizer_name, synthesizer_description | — | Nombre y descripción, que aparecen en los metadatos y en el informe. |
Tipos de columnas (dentro de configuration):
| Clave | Formato | Descripción |
|---|---|---|
categorical_columns | lista | Columnas con valores discretos. |
integer_columns | lista | Números enteros. |
float_columns | lista | Números decimales. |
boolean_columns | lista | Verdadero/falso. |
date_columns | lista o \{columna: formato\} | Fechas. Con diccionario, los datos generados se escriben en ese formato ("%Y-%m-%d"). |
id_columns | lista o \{columna: patrón\} | Identificadores. Con patrón (r"ID_\d\{4\}"), se generan a partir de él; en una lista, se numeran 0, 1, 2… |
text_columns | \{columna: instrucción\} | Columnas de texto libre (ver Columnas de texto libre y privacidad). |
target | texto | La columna que más te interesa predecir. Se usa para medir la utilidad en la evaluación. |
Las columnas que no declares se clasifican solas, y la librería indica cómo las ha clasificado. Ninguna columna se descarta: si no quieres que una columna entre en el modelo, elimínala de los datos antes de entrenar.
> Los tipos de columnas van dentro de configuration. Pasarlos como argumentos sueltos (categorical_columns=[…]), como en versiones anteriores, produce un error al crear el modelo.
Transaccional
Para movimientos de una entidad a lo largo del tiempo. Indica en columns_mapping qué columna de tus datos cumple cada papel:
| Papel | Significado | Obligatorio |
|---|---|---|
txn_date | Fecha del movimiento | Sí |
amount | Importe (negativo = gasto, positivo = ingreso) | Sí |
concept | Descripción del movimiento | Sí |
user_id | Cliente o cuenta | No (sin ella, se asume una sola historia) |
balance | Saldo | No |
cat_id | Categoría del movimiento | No |
from dedomena.nucleus import Transactional

modelo = Transactional(

    columns_mapping=\{"user_id": "cuenta", "txn_date": "fecha", "amount": "importe",

                     "concept": "concepto", "balance": "saldo", "cat_id": "categoria"\},

    balance_updated=True,

    transform_descriptions="level2",

    configuration=\{"categorical_columns": ["categoria"], "date_columns": \{"fecha": "%Y-%m-%d"\}\},

    datasets_country="Spain",

    epochs=250,

    synthesizer_name="movimientos_v1",

)

modelo.train("datos/movimientos.parquet")

modelo.save("sintetizadores/movimientos")
-
balance_updated:Truesi el saldo de cada fila ya incluye el importe de esa fila;Falsesi incluye el de la fila anterior. El saldo de los datos generados se recalcula a partir de los importes. -
Con una columna
cat_id, se mantiene la coherencia entre descripción y categoría.
Descripciones de los movimientos (transform_descriptions, por defecto "level2"): las descripciones generadas se reescriben para que no repitan textos reales y sean coherentes con el importe y la fecha de su fila.
| Nivel | Qué se sustituye en la descripción |
|---|---|
level1 | Fechas, importes, números de tarjeta y de cuenta (IBAN). |
level2 | Todo lo anterior, más nombres de personas, direcciones y ciudades. |
level3 | Todo lo anterior, más nombres de comercios, sustituidos por otros del mismo sector (por ejemplo, una cadena de comida rápida por otra). |
Los niveles 2 y 3 aprovechan los modelos de detección y de texto si están instalados. Sin ellos, se apoyan en patrones y en valores ficticios.
Series temporales
Para medidas periódicas de varias entidades. Indica en columns_mapping la entidad (user_id), la fecha (txn_date) y la medida (amount). Hacen falta al menos 5 entidades distintas.
from dedomena.nucleus import TimeSeries

modelo = TimeSeries(

    columns_mapping=\{"user_id": "contador", "txn_date": "fecha", "amount": "kwh"\},

    static_columns=["tarifa", "provincia"],     # constantes para cada entidad

    epochs=300,

    batch_size=64,

)

modelo.train("datos/lecturas.csv")

modelo.save("sintetizadores/lecturas")
-
Las series se modelan con una observación por día. Otras columnas de fecha distintas de
txn_dateno se usan. -
Cuando generes datos a partir de un sintetizador de series temporales, la cantidad que pides es el número de series (entidades), no de filas.
Relacional
Para varias tablas relacionadas. Describe cada tabla en datasets_config y pasa los datos de todas a train():
from dedomena.nucleus import Relational

config = \{

    "clientes": \{

        "primary_key": "id_cliente",

        "categorical_columns": ["segmento", "provincia"],

        "integer_columns": ["edad"],

        "sensitive": \{"nombre": "name"\},

        "amplify": "default",

    \},

    "pedidos": \{

        "primary_key": "id_pedido",

        "foreign_key": \{"id_cliente": "clientes"\},

        "date_columns": ["fecha_pedido"],

        "float_columns": ["total"],

        "amplify": "default",

    \},

\}

modelo = Relational(datasets_config=config, epochs=200, datasets_country="Spain",

                    synthesizer_name="tienda_v1")

modelo.train(\{"clientes": "datos/clientes.csv", "pedidos": "datos/pedidos.parquet"\})

modelo.save("sintetizadores/tienda")
Claves por tabla en datasets_config:
| Clave | Descripción |
|---|---|
primary_key | Clave primaria de la tabla (valores únicos). |
foreign_key | \{columna: "tabla"\}: la columna apunta a la clave primaria de esa tabla. Si la columna se llama distinto: \{columna: \{"dataset": "tabla", "field": "clave"\}\}. |
categorical_columns, integer_columns, float_columns, boolean_columns, date_columns | Tipos de columna de la tabla. |
text_columns, sensitive, target, constraints, columns_mapping, max_categories, min_freq_categories, num_cat, drop_primary | Igual que en las demás clases, para esa tabla. |
algorithm | "generic" (por defecto) o "transactional". Con "transactional", también transform_descriptions y balance_updated. |
impute | Por defecto False en relacional. |
amplify | Por defecto "quality" en relacional. Indica "default" en cada tabla si quieres registros nuevos y máxima privacidad (ver Opciones comunes). |
-
Las relaciones deben formar un grafo sin ciclos, y cada clave ajena debe apuntar a una clave primaria. Las filas con claves que no apuntan a nada se descartan al entrenar, con un aviso.
-
El entrenamiento relacional requiere 150 o más pasadas.
-
Cuando generes datos a partir de un sintetizador relacional, la cantidad que pides es el número de copias completas del esquema. Las claves siguen coincidiendo entre las tablas generadas.
-
Un sintetizador relacional no se puede reentrenar: entrena uno nuevo con los datos actualizados.
Restricciones
Reglas que los datos generados cumplen siempre. Se escriben sin espacios:
| Forma | Significado |
|---|---|
col1\<-\>col2\<-\>col3 | Solo se generan combinaciones que existen en los datos reales (por ejemplo, descripción ↔ subcategoría ↔ categoría). |
col1\<=col2, col1\<col2, col1\ />=col2, col1\>col2 | Comparación entre dos columnas (por ejemplo, fecha_alta\<=fecha_baja). |
col1\<=col2\<=col3 | Orden entre tres columnas. |
col1\>0, col1\>=0, col1\<0, col1\<=0 | Valores positivos o negativos. |
col1\>=18 | Valor mínimo (número entero). |
0\<=col1\<=100 | Valor entre un mínimo y un máximo (números enteros). |
col1//1000 | Múltiplo de 1000. |
Una restricción mal escrita produce un error al entrenar.
Generar datos
Los datos sintéticos se generan en la plataforma Dedomena.AI, a partir del sintetizador que entrenas con Edge:
-
Guarda el sintetizador con
modelo.save(carpeta). Escribesynthesizer.zipen esa carpeta. -
Sube
synthesizer.zipa la plataforma Dedomena.AI, desde la aplicación web o a través de la API. -
Genera los datos sintéticos desde la plataforma, o a través de la API.
Las opciones de generación (número de registros, generación condicional…) se describen en la documentación de la plataforma y de la API. Los datos sintéticos se marcan siempre como contenido generado por IA.
Guardar, cargar y reentrenar
modelo.save("sintetizadores/clientes")            # → sintetizadores/clientes/synthesizer.zip

modelo = load_synthesizer("sintetizadores/clientes/synthesizer.zip")

modelo.metadata                                    # nombre, algoritmo, columnas, puntuaciones…
-
save()recibe una carpeta y escribe siempresynthesizer.zipdentro. Si has ejecutadoevaluate()antes, el informe va incluido. -
load_synthesizer(ruta)carga un sintetizador guardado, por ejemplo para reentrenarlo. -
Protege
synthesizer.zipcomo un dato sensible: contiene el modelo entrenado y puede contener muestras de los datos de entrenamiento.
Reentrenar con datos nuevos (solo Generic, Transactional y TimeSeries):
modelo = load_synthesizer("sintetizadores/clientes/synthesizer.zip")

modelo.retrain(data="datos/clientes_noviembre.csv", epochs=100)

modelo.save("sintetizadores/clientes_v2")
-
Indica siempre
epochs. -
Con
amplify="quality",forgetfulness_factor(entre 0 y 1) decide qué parte de los datos anteriores se olvida:0conserva todo,1empieza de cero.
Evaluación e informe
privacidad, calidad, utilidad = modelo.evaluate(output_dir="informe")
Mide el sintetizador frente a los datos reales con los que se entrenó y devuelve tres puntuaciones de 0 a 100:
| Puntuación | Qué mide |
|---|---|
| Privacidad | Lo difícil que es relacionar los datos sintéticos con personas reales: copias exactas, cercanía a registros reales, riesgo de singularización y de vinculación. |
| Calidad | Lo bien que se conservan las distribuciones, las correlaciones y la cobertura de los datos reales (y los patrones temporales, si hay fechas). |
| Utilidad | Si un modelo de aprendizaje automático entrenado con datos sintéticos rinde como uno entrenado con datos reales, sobre la columna target. |
En output_dir se escriben:
-
report.pdf: el informe, con las puntuaciones, cada métrica explicada y sus gráficos; -
evaluation.json: los mismos resultados en formato de datos, para integrarlos en tus procesos; -
logHistory.log.
Cada puntuación se acompaña de una valoración: crítica (hasta 40), mejorable (hasta 60), aceptable (hasta 80) o excelente.
-
Datos de control. Para medir los riesgos de singularización y de vinculación, separa antes de entrenar una parte de los datos reales que el modelo no vea y pásala como
control_data:modelo.evaluate(output_dir="informe", control_data="datos/control.csv"). -
La evaluación necesita al menos 3 columnas tipadas que no sean sensibles ni identificadores.
-
Ejecuta
evaluate()antes desave()para que el informe vaya dentro del sintetizador. -
En relacional,
evaluate(output_dir=…)devuelve las puntuaciones medias e incluye la integridad referencial.
Evaluar dos conjuntos de datos cualesquiera. Para comparar un conjunto real con datos sintéticos que hayas generado en la plataforma Dedomena.AI:
from dedomena.nucleus.evaluations import synthesizer_evaluations

privacidad, calidad, utilidad = synthesizer_evaluations(

    real_data="datos/real.parquet",

    synthetic_data="datos/sintetico.parquet",

    categorical_columns=["provincia", "segmento"],

    integer_columns=["edad"],

    float_columns=["ingresos"],

    date_columns=["fecha_alta"],

    target="segmento",

    output_dir="informe",

    synthesizer_name="clientes_v1",

)
Para varias tablas, synthesizer_evaluations_multitable(configuration=\{tabla: \{...\}\}, output_dir="informe") produce un único informe combinado.
Columnas de texto libre y privacidad
Las columnas de texto libre (text_columns) se modelan como categorías: los textos generados se toman de los textos reales del entrenamiento. Si esas columnas contienen datos personales, anonimízalas antes de entrenar, por ejemplo con coding o text_regenerate (ver Anonimización), o elimínalas de los datos.
La excepción son las descripciones de los movimientos en Transactional con transform_descriptions, que se reescriben al generar (ver Transaccional).
Partir de datos preparados con Axon
Si pasas a train() un activo preparado con Axon, el sintetizador aprovecha los tipos de columna que Axon ha detectado. Lo que declares tú en configuration tiene prioridad. Ver De Axon a Nucleus.
Axon: calidad y preparación de datasets
Axon comprueba y prepara un dataset antes de anonimizarlo o sintetizarlo: infiere los tipos de las columnas, detecta valores atípicos y patrones de valores ausentes, limpia el texto, aplica reglas de transformación y genera un informe de calidad en PDF. Va incluido en todos los paquetes y requiere el permiso axon.
Cada paso devuelve un nuevo activo y deja el original sin modificar; el historial se acumula.
Inspeccionar
from dedomena.axon import Inspector

activo = Inspector().run("datos/clientes.csv", name="clientes")

activo.schema["types"]       # categorical_columns, integer_columns, float_columns, boolean_columns, text_columns, date_columns

activo.schema["semantic"]    # columnas de identificadores, teléfonos, emails/URL, coordenadas…

activo.schema["outliers"]    # \{columna: [filas con valores atípicos]\}

activo.info["rows"], activo.info["columns"]

activo.info["axon"]["unavailable"]   # \{\} si se pudo ejecutar todo
Opción de Inspector | Por defecto | Descripción |
|---|---|---|
profile | True | Perfil estadístico de cada columna. |
outliers | True | Valores atípicos en columnas numéricas. |
correlations | True | Correlaciones entre columnas. Desactívalo en tablas muy anchas. |
semantic | True | Tipos semánticos (identificadores, teléfonos, emails, coordenadas…). |
missing | True | Patrones de valores ausentes. |
sample | — | Analizar solo las primeras N filas, para tablas muy grandes. |
La forma corta es inspect_dataset(fuente, **opciones).
Limpiar
from dedomena.axon import clean

limpio = clean("datos/clientes.csv", name="clientes")

limpio.info["axon"]["cleaning"]      # filas duplicadas, cabeceras repetidas, vacíos, espacios corregidos…

limpio.quality["cleaning_after"]     # indicador orientativo de 0 a 1
La limpieza:
-
sustituye tabuladores y saltos de línea por espacios, junta espacios repetidos y recorta los extremos de cada celda;
-
elimina comillas tipográficas o desparejadas;
-
convierte a número las columnas con decimales escritos con coma (
"1,5").
También cuenta las filas duplicadas y las cabeceras repetidas dentro de los datos, pero no las elimina. Elimínalas tú si lo necesitas, por ejemplo con df.drop_duplicates().
Después de limpiar, las columnas quedan como texto. Para devolverles su tipo, aplica reglas cast_type (siguiente apartado) y vuelve a inspeccionar.
Aplicar reglas
from dedomena.axon import ApplyRules, Inspector

reglas = \{

    "email":   \{"type": "normalize_nulls"\},

    "nombre":  \{"type": "normalize_text_casing", "params": \{"proposed_case": "title"\}\},

    "edad":    [\{"type": "cast_type", "params": \{"target_type": "integer", "mode": "force"\}\},

                \{"type": "nullify_out_of_range", "params": \{"min": 0, "max": 120\}\}],

    "importe": \{"type": "cast_type", "params": \{"target_type": "float", "mode": "force"\}\},

    "ciudad":  \{"type": "enforce_category", "params": \{"allowed": ["Madrid", "Barcelona", "Valencia"]\}\},

\}

preparado = ApplyRules(reglas).run(limpio, name="clientes")

preparado.lineage[-1].details["applied"]   # reglas aplicadas por columna

preparado.lineage[-1].details["failed"]    # reglas que no se pudieron aplicar (p. ej. columna inexistente)

preparado = Inspector().run(preparado, name="clientes")   # tipos finales
Cada columna recibe una regla o una lista de reglas, que se aplican en orden:
| Regla | Parámetros | Qué hace |
|---|---|---|
normalize_nulls | — | Convierte en vacío null, none, nan, na, n/a, -, -- y cadenas vacías. |
cast_type | target_type: float, integer, string, category, boolean, datetime; mode: force | Cambia el tipo de la columna. Entiende decimales europeos (1.234,56) y booleanos en español e inglés (sí/no, yes/no, 1/0). Con mode: "force", los valores que no se pueden convertir quedan vacíos; sin él, se conservan. |
format_datetime | strftime | Escribe las fechas en el formato indicado. |
normalize_text_casing | proposed_case: upper, lower, title | Mayúsculas, minúsculas o tipo título. |
impute_nulls | method: median, median_int, mode, ffill, constant (con value) | Rellena los valores ausentes. |
nullify_out_of_range | min, max | Deja vacíos los valores fuera del rango. |
clamp_range | min, max | Ajusta al límite los valores fuera del rango. |
enforce_category | allowed (lista) | Corrige mayúsculas y tildes hacia el valor permitido y deja vacíos los que no lo son. |
enforce_format | pattern (# = una letra o cifra, * = cualquier cosa) | Deja vacíos los valores que no siguen el patrón. |
replace_value | mapping, case_sensitive, regex | Sustituye valores. |
round_decimals | decimals (por defecto 2) | Redondea. |
Para que la anonimización y la síntesis vean el tipo nuevo de una columna, usa cast_type con "mode": "force".
Informe de calidad en PDF
from dedomena.axon import report

ruta = report(preparado, "informes/calidad_clientes", lang="es", name="Clientes 2026")

# → 'informes/calidad_clientes.pdf'
-
lang:"es"o"en". -
El informe se construye con lo que el activo ya sabe: inspecciona antes de generarlo.
-
El informe incluye ejemplos de valores de cada columna. Trátalo con la misma confidencialidad que el dataset. Lo mismo aplica a
meta.jsoncuando guardas un activo inspeccionado.
Riesgo e informe ejecutivo
Estas dos funciones necesitan el modelo de lenguaje: el módulo Texto con un modelo instalado.
from dedomena.detection import detect, llm

from dedomena.axon import risk, insight, report

llm.register()                                       # necesario para insight()

preparado.sensitive_elements = detect(preparado)     # detecta antes de calcular el riesgo

con_riesgo = risk(preparado, name="clientes")

resumen = con_riesgo.info["risk"]["summary"]

resumen["label"], resumen["level"], resumen["sensitivity_index"], resumen["avg_risk_level_sensitive"]

con_insight = insight(con_riesgo, language="spanish", context="Altas del canal online", rows=200)

print(con_insight.info["insight"]["text"])

report(con_insight, "informes/riesgo_clientes.pdf", lang="es")   # añade las secciones de riesgo e insights
-
risk()calcula el nivel de riesgo de reidentificación a partir de las columnas sensibles detectadas: ejecutadetect()antes; sin detección, el resultado es «sin riesgo». -
insight()escribe un resumen ejecutivo de lo que dicen los datos, a partir de las primerasrowsfilas.languageadmite"spanish"o"english".
De Axon a Nucleus
El flujo recomendado:
-
Inspeccionar los datos originales con
Inspector, para tener un diagnóstico. -
Limpiar con
clean. -
Aplicar reglas con
ApplyRules, usandocast_typecon"mode": "force"para fijar los tipos. -
Volver a inspeccionar con
Inspector, para que el esquema describa los datos ya preparados. -
Anonimizar o sintetizar con Nucleus.
from dedomena.nucleus import anonymize, Generic

anonimizado = anonymize(preparado, config="auto", output="salida/clientes_anon.csv")

modelo = Generic()

modelo.train(preparado)          # usa los tipos que ha detectado Axon
-
Síntesis: usa los tipos de columna de Axon para todo lo que no hayas declarado en
configuration. -
Anonimización: usa el contenido limpio y, si el activo ya tiene elementos detectados, los usa sin volver a detectar.
-
Indica siempre
output=al anonimizar un activo de Axon (ooutput_format="DATAFRAME").
Comprobar el motor de Axon
from dedomena.axon import engine_report

engine_report()      # \{'basic_cleaner': None, 'profiling': None, ...\}   None = funciona
Si una parte no puede ejecutarse en tu máquina (por ejemplo, por una dependencia), Inspector la omite, avisa y la anota en activo.info["axon"]["unavailable"] con el motivo. El resto del análisis continúa.
Modelos: automáticos, registrados y propios
Cómo elige la librería
No tienes que configurar nada: la librería usa el mejor motor que encuentra instalado para cada modalidad.
| Modalidad | Orden de preferencia |
|---|---|
| Texto | Modelo de texto completo → modelo de texto ligero → solo patrones |
| Imagen (también páginas escaneadas y fotogramas de vídeo) | Modelo de imagen completo → modelo de imagen ligero → error: hace falta un modelo |
| Audio | Transcripción ligera → transcripción completa |
-
Los patrones y las validaciones se aplican siempre, con cualquier motor.
-
Al cargarse, cada motor deja una línea en el registro con lo elegido y el dispositivo (
text detection engine selected: …,small-text device selected: cpu…). -
Si un motor no se puede cargar, la librería pasa al siguiente y lo avisa. Si lo que falta son los modelos, el aviso incluye el comando para descargarlos:
codetext detection engine selected: patterns (...). Download the models with your licence: `dedomena-edge setup --size small`. -
Los modelos ligeros se ejecutan en CPU aunque haya GPU, para no ocupar memoria de la tarjeta. Puedes moverlos a la GPU (ver Registrar un modelo explícitamente).
Qué motor se va a usar
from dedomena.detection import models

print(models.report())          # qué se usará en cada modalidad, y si cabe en la GPU
GPU: 96 GB

residency: shared

runs on:

  audio: small-audio on cpu

  images: …

  text: …
-
models.runtime_report()devuelve lo mismo como diccionario. -
models.plan()indica, para los modelos completos, si caben en tu GPU:fits(caben),tight(caben reduciendo el contexto) ono(no caben). -
Nada de esto carga los modelos.
Por modalidad:
from dedomena.detection import llm, small, audio

llm.model_report()                     # (ruta, motor, problema): problema None = se puede cargar

small.report()                         # modelos ligeros disponibles, y qué falta

audio.transcriber_report(device="auto")
Registrar un modelo explícitamente
Registrar un modelo lo carga en memoria y lo conecta con la detección y la anonimización. La librería lo hace sola cuando lo necesita, pero registrarlo tú te permite elegir qué capacidades activar, en qué dispositivo y cuándo pagar el tiempo de carga.
Modelo de lenguaje (módulo Texto):
from dedomena.detection import llm

llm.register()        # con los modelos instalados
Opción de llm.register | Por defecto | Qué activa |
|---|---|---|
model | — | Ruta a un modelo concreto (ver Usar un modelo que ya tienes). |
detect | True | El modelo detecta los datos sensibles en texto libre (además de los patrones). |
generate | True | Habilita text_regenerate y la reescritura de textos. Necesario para text_regenerate. |
confirm | False | El modelo revisa los elementos que otro detector propone: elimina falsos positivos y corrige tipos, nunca añade. Útil con detect=False (los patrones proponen y el modelo juzga) o con elementos que llegan ya detectados. |
insight | True | Habilita axon.insight(). |
| otros | — | Opciones del motor, como n_ctx (contexto, 8192 por defecto) o temperature (0 por defecto, para resultados reproducibles). |
llm.unregister() vuelve a dejar la detección de texto en los patrones. llm.available() indica si se puede cargar.
> text_regenerate necesita registrar el modelo. La detección automática carga el modelo de lenguaje solo para detectar. Para usar text_regenerate, llama antes a llm.register().
Modelos ligeros:
from dedomena.detection import small

small.register(device="cuda")    # mueve a la GPU los modelos ligeros de texto e imagen

small.upgrade()                  # cambia los ligeros por los completos, si están instalados
Modelo de imagen completo:
from dedomena.detection.images import vlm

vlm.register(confirm=True)       # además, revisa cada región propuesta recortándola
Usar un modelo que ya tienes
Si tu organización ya tiene un modelo de lenguaje propio, Edge puede usarlo para la detección en texto libre, text_regenerate y los informes ejecutivos de Axon. Necesitas el módulo Texto.
Requisitos del modelo:
-
Un modelo de lenguaje conversacional (instruido para seguir instrucciones), con un contexto de al menos 8.192 tokens.
-
Multilingüe, si tus datos no están en inglés.
-
Edge le envía sus propias instrucciones. La calidad de la detección depende del modelo: compruébala con tus datos antes de usarlo en producción.
Opción 1: tus pesos, en tu disco
Indica la ruta del modelo:
export DEDOMENA_LLM_MODEL=/modelos/mi-modelo
o al registrarlo:
from dedomena.detection import llm

llm.register(model="/modelos/mi-modelo")
| Formato | Dónde se ejecuta | Qué necesitas |
|---|---|---|
Carpeta de modelo estándar, con config.json, el tokenizador y los pesos | GPU con memoria suficiente (motor de GPU, dedomena-edge[gpu]); sin GPU, en CPU, mucho más despacio | Hardware gpu para usar la GPU |
Un único fichero .gguf cuantizado | CPU | El extra text y un compilador de C++ para instalarlo: pip install --index-url "https://licence:\<TOKEN\>@api.dedomena.ai/edge/\<módulos\>/cpu/simple/" "dedomena-edge[text]" |
Si la carpeta contiene a la vez una carpeta de modelo y un .gguf, gana la carpeta.
Opción 2: tu propio servidor de modelos
Si ya sirves un modelo en tu red interna con una API compatible con la de chat de OpenAI (/v1/chat/completions):
export DEDOMENA_LLM_ENDPOINT=http://modelos.interno:8000      # sin /v1

export DEDOMENA_LLM_ENDPOINT_MODEL=nombre-del-modelo-en-tu-servidor
from dedomena.detection import llm

llm.register()
-
Edge llama a
\<DEDOMENA_LLM_ENDPOINT\>/v1/chat/completions. -
El servidor debe estar en tu red: así los datos siguen sin salir de tu infraestructura.
-
Edge no envía cabecera de autenticación. Si tu servidor la exige, publícalo detrás de un proxy interno que la añada.
-
Con esta variable definida, Edge usa el servidor en lugar de un modelo local.
Modelo de imagen propio
Funciona igual con DEDOMENA_VISION_MODEL (una carpeta de modelo) o con DEDOMENA_VISION_ENDPOINT y DEDOMENA_VISION_ENDPOINT_MODEL (un servidor compatible). Edge le pide localizar regiones (rostros, firmas, logotipos, huellas) y valores dentro de la imagen, y devolver sus coordenadas, así que debe ser un modelo de visión y lenguaje capaz de hacerlo. Te recomendamos usar el modelo de imagen de Dedomena.AI, salvo que valides el tuyo con tus documentos.
Forzar un motor
La librería elige sola cómo ejecutar el modelo según su formato y tu hardware. Si necesitas forzar otra forma de ejecutarlo (por ejemplo, porque la GPU está ocupada con otro proceso), consulta con soporte de Dedomena.AI las variables DEDOMENA_LLM_BACKEND y DEDOMENA_VISION_BACKEND.
Registrar un detector propio
Si tienes tu propio detector (por ejemplo, un modelo interno para un tipo de documento propio), puedes conectarlo y todas las funciones de la librería lo usarán en lugar del motor incorporado:
from dedomena.detection import register_detector, detect

def mi_detector_de_texto(texto, types=None):

    """Recibe un texto y devuelve los elementos que encuentra."""

    resultados = []

    for numero in buscar_numeros_de_poliza(texto):          # tu lógica

        resultados.append(\{"value": numero, "type": "health_card"\})

    return resultados

register_detector("text", mi_detector_de_texto)

detect("La póliza AX-99812 está a nombre de…")
| Canal | Recibe | Devuelve |
|---|---|---|
"text" | (texto, types=None) | [\{'value', 'type'\}], con start/end opcionales (si no se indican, se buscan todas las apariciones del valor en el texto) |
"image" | Una imagen (PIL) | [\{'value', 'type', 'box': (x0, y0, x1, y1)\}] |
"audio" | (ruta, language=None) | Segmentos con value, type, start, end (segundos) |
-
Los patrones siguen aplicándose antes que tu detector y ganan los solapamientos.
-
Un valor de texto que no aparece literalmente en el texto se descarta.
-
Si tu detector falla, la librería vuelve a los patrones para ese lote y lo avisa en el registro.
-
Para quitarlo:
from dedomena.detection.registry import unregister_detector; unregister_detector("text").
Del mismo modo, register_generator("text_regenerate", funcion) permite conectar tu propio generador de texto. La función recibe (prompts, max_tokens=...) y devuelve una cadena por cada instrucción.
Dónde están los modelos
La librería busca cada modelo en este orden:
-
La ruta que indiques al registrarlo (
model=). -
Su variable de entorno:
DEDOMENA_LLM_MODEL,DEDOMENA_VISION_MODEL,DEDOMENA_AUDIO_MODEL,DEDOMENA_SMALL_TEXT_MODEL,DEDOMENA_SMALL_VISION_MODEL,DEDOMENA_SMALL_AUDIO_MODEL… -
La carpeta de modelos:
DEDOMENA_MODELS_DIR, o~/.local/share/dedomena/modelssi no está definida.
dedomena-edge setup descarga en la misma carpeta en la que la librería busca, así que no tienes que configurar nada. Con la descarga completa, env.sh define DEDOMENA_MODELS_DIR apuntando a ./models.
Integridad. Cada modelo lleva un manifiesto con el tamaño y la huella de cada fichero. La huella se comprueba al descargar, y el tamaño cada vez que se carga: un modelo copiado a medias no se usa.
GPU: memoria y uso compartido
Si tu paquete tiene los modelos completos de texto y de imagen, los dos comparten la GPU:
-
si caben a la vez, se cargan los dos (
shared); -
si no, se cargan por turnos (
exclusive): cada uno dispone de la tarjeta entera y el otro se descarga al cambiar. Cada cambio cuesta una carga, así que ordena el trabajo por modalidad (primero las tablas, después las imágenes).
La librería lo decide midiendo la tarjeta. Puedes forzarlo con DEDOMENA_GPU_POLICY=shared|exclusive, y fijar la fracción de memoria de cada modelo con DEDOMENA_LLM_VRAM y DEDOMENA_VISION_VRAM (por ejemplo, 0.45).
Manual de referencia
Comandos
| Comando | Qué hace |
|---|---|
bash install.sh \<TOKEN\> [--venv | --no-venv] | Instala desde la descarga completa (ver Opción A: descarga completa (sin internet en la máquina de destino)). |
. ./env.sh | Carga el entorno de una instalación hecha con install.sh. |
dedomena-edge setup --size small|full|none [--token …] [opciones] | Descarga los modelos de tu instalación y guarda la licencia (ver Opción B: instalación con pip). |
dedomena-edge status | Muestra la versión, los módulos, la carpeta de modelos, si hay GPU y los modelos instalados. |
Variables de entorno
Todas son opcionales: sin ninguna, la librería decide sola.
| Variable | Para qué |
|---|---|
DEDOMENA_TOKEN | La licencia, sin guardarla en disco. |
DEDOMENA_NO_PERSIST | Con 1, la librería no escribe nada en el directorio del usuario. |
DEDOMENA_CONFIG_DIR | Carpeta del fichero de licencia (por defecto ~/.config/dedomena). |
DEDOMENA_MODELS_DIR | Carpeta de los modelos (por defecto ~/.local/share/dedomena/models). |
DEDOMENA_LLM_MODEL, DEDOMENA_VISION_MODEL, DEDOMENA_AUDIO_MODEL | Ruta de un modelo completo concreto. |
DEDOMENA_SMALL_TEXT_MODEL, DEDOMENA_SMALL_VISION_MODEL, DEDOMENA_SMALL_AUDIO_MODEL | Ruta de un modelo ligero concreto. |
DEDOMENA_LLM_ENDPOINT, DEDOMENA_LLM_ENDPOINT_MODEL | Tu servidor de modelos de lenguaje y el nombre del modelo en él. |
DEDOMENA_VISION_ENDPOINT, DEDOMENA_VISION_ENDPOINT_MODEL | Tu servidor de modelos de imagen y el nombre del modelo en él. |
DEDOMENA_LLM_BACKEND, DEDOMENA_VISION_BACKEND | Fuerzan la forma de ejecutar el modelo. Solo con indicación de soporte (ver Usar un modelo que ya tienes). |
DEDOMENA_GPU_POLICY | shared o exclusive (ver GPU: memoria y uso compartido). |
DEDOMENA_LLM_VRAM, DEDOMENA_VISION_VRAM | Fracción de la memoria de la GPU para cada modelo. |
DEDOMENA_LOG_FILE | Ruta del registro de la ejecución. |
Errores frecuentes
| Mensaje | Causa y solución |
|---|---|
No Dedomena token found | No hay licencia. Guárdala con dedomena.login("\<TOKEN\>", persist=True) o define DEDOMENA_TOKEN. |
Your Dedomena token expired on … | La licencia ha caducado. Genera un token nuevo en la página Edge y guárdalo. |
Your Dedomena licence does not cover … | Tu licencia no incluye ese permiso (ver Permisos). |
… is not part of this build. It includes: … | Tu paquete no incluye ese módulo. Instala un paquete con él (ver Actualizar, ampliar o cambiar la instalación). |
'Auto' needs the tables module, which is not part of this build | La síntesis está en el módulo Tablas (o Texto). |
Image detection needs a vision model and none is installed | Ejecuta dedomena-edge setup --size small (o full). |
These models need an NVIDIA GPU … | Los modelos completos de texto e imagen necesitan GPU. Usa --size small. |
Unknown anonymization method '…' | El método no existe. Revisa Métodos de anonimización. |
None of the columns could be reversed | El mapeo de mapping_dir no corresponde a ese fichero. |
IBM Db2 driver not found | Copia db2jcc4.jar en la carpeta DB2Driver del paquete (ver Fuentes de datos). |
Dedomena error [id]: … Details were written to …/logHistory.log | Consulta el registro. Si necesitas ayuda, envía a soporte el identificador, el registro y dedomena-support.enc. |