Introducción
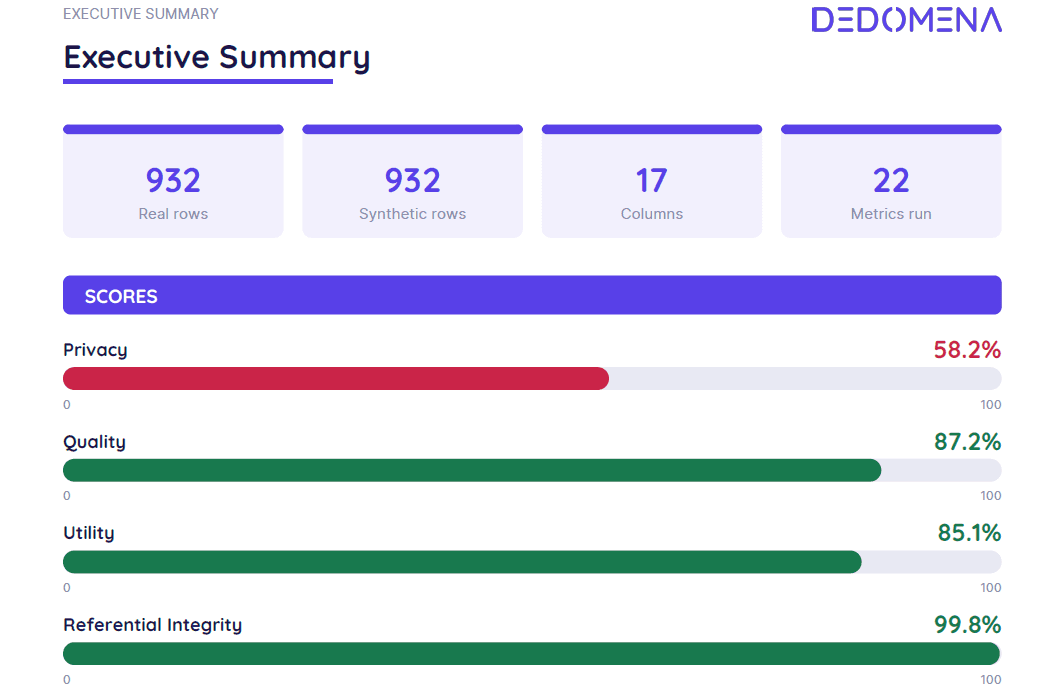
Cuando uno de los algoritmos de sintetización de Dedomena termina de entrenar, Nucleus puede evaluar el resultado y producir dos documentos a la vez:
-
report.pdf— el informe que lee una persona. -
evaluation.json— el mismo contenido como datos, para consumirlo con código.
Los dos salen del mismo objeto de evaluación, así que no pueden decir cosas distintas. El JSON lleva además todas las figuras que el PDF muestra en parte: una pantalla puede desplazarse, un PDF no.
Para qué sirve el JSON
Es la evaluación en forma de dato, y con eso se pueden hacer cosas que un PDF no permite:
-
Comparar sintetizadores entre sí, métrica a métrica, en lugar de a ojo entre dos documentos.
-
Decidir sobre el entrenamiento con código. Si la utilidad sale por debajo de un umbral, volver a entrenar con más épocas; si la privacidad sale baja, reentrenar o cambiar de algoritmo. La decisión deja de ser manual.
-
Programar reentrenamientos y seguir la evolución de una misma tabla a lo largo del tiempo.
-
Integrar el resultado en un panel, un informe propio o una puerta de calidad dentro de una canalización de datos.
El JSON declara su versión en meta.schema_version, hoy 1.4. Conviene fijarla: un campo que se mueve es una versión que puedes rechazar, en lugar de un gráfico que aparece vacío sin avisar o una comparación entre dos ejecuciones que ya no compara lo mismo.
Para calcular las métricas se toma una muestra de datos reales y sintéticos, de forma que el cálculo no se convierta en un cuello de botella.
Scores

Dedomena da tres scores, y un cuarto cuando el conjunto es relacional:
| Score | Qué responde |
|---|---|
| Privacy | Si un individuo de los datos reales puede encontrarse en los sintéticos, o inferirse a partir de ellos. |
| Quality | Si los datos sintéticos reproducen las distribuciones de los reales y las relaciones entre sus columnas. |
| Utility | Si los datos sintéticos sirven para entrenar modelos que funcionen sobre datos reales. |
| Referential Integrity | (solo multitabla) Si las tablas siguen sosteniéndose como un esquema. |
Los cuatro van de 0 a 100 y comparten los mismos cortes:
| Banda | Rango | Color en el informe |
|---|---|---|
excellent | > 80 | verde |
fair | 60 – 80 | ámbar |
poor | 40 – 60 | rojo |
critical | ≤ 40 | rojo |
Una métrica sin medir no es una métrica mala
Cuando algo no se puede calcular sobre unos datos concretos —Cramér's V necesita dos columnas categóricas, las métricas de fecha necesitan una columna de fecha— la métrica se marca no aplicable y su peso se reparte entre las que sí se calcularon. No se rellena con un cero ni con un valor por defecto: en el JSON viaja como applicable: false con la razón, y en el PDF sale en blanco.
Es la diferencia entre «lo medimos y salió mal» y «no se pudo medir», y un número solo nunca la dice.
Privacy
| Métrica | Qué mide | Óptimo | Bandas |
|---|---|---|---|
| Relative DCR | Distancia de cada registro real a su vecino sintético más cercano, dividida por lo que separa a los propios registros reales en el mismo percentil. | alto | excellent > 0.95 · fair ≤ 0.95 · poor ≤ 0.8 · critical ≤ 0.5 |
| Exact Match Score (EMS) | Proporción de filas sintéticas que reproducen una real exactamente. | 0 | excellent = 0 · good ≤ 0.1 · poor ≤ 0.5 · critical > 0.5 |
| Nearest Neighbour Distance Ratio (NNDR) | Razón entre la distancia al vecino más cercano y al segundo. | alto | excellent > 0.7 · fair ≤ 0.7 · critical ≤ 0.1 |
| Authenticity (relative) | Proporción de registros sintéticos que no son casi copias de un registro real concreto, dividida por esa misma proporción medida entre los propios reales. | alto | excellent > 0.9 · fair ≤ 0.9 · poor ≤ 0.7 · critical ≤ 0.3 |
| Attribute Inference Attack (AIA) | Si se puede inferir un atributo real a partir de los sintéticos. | alto | excellent > 0.8 · poor ≤ 0.8 |
| Singling Out Risk (con control) | Riesgo de aislar a un individuo, normalizado contra el mismo ataque sobre el conjunto de control. | 0 | excellent ≤ 0.0025 · good ≤ 0.01 · poor ≤ 0.05 · critical > 0.05 |
| Linkability Risk (con control) | Riesgo de vincular dos registros del mismo individuo, igualmente normalizado. | 0 | igual que el anterior |
El conjunto de control
Las dos últimas —Singling Out y Linkability— solo se calculan si se aporta un conjunto de control: una partición de los datos reales que el modelo nunca vio durante el entrenamiento.
Hay que reservarlo antes de entrenar. Recortarlo de los datos de entrenamiento después no mide nada: los dos ataques son, por definición, la diferencia entre lo que consigue un atacante sobre quien estaba en el entrenamiento y lo que consigue sobre quien no estaba. Sin esa diferencia no hay riesgo que normalizar.
Sin conjunto de control, esas dos métricas no aparecen en el informe, y su peso se reparte entre las demás. No se estiman a partir de los propios datos de entrenamiento.
Por qué DCR y Authenticity son relativas
Las dos tienen el mismo problema en su forma cruda: su valor nulo depende de la forma de los datos, no de la calidad del sintetizador.
-
Un DCR absoluto está en las unidades del espacio codificado. Solo se podía comparar contra otra ejecución del mismo conjunto.
-
La autenticidad cruda crece con el ancho de la tabla: un sintético impecable saca alrededor de 0.50 en cinco columnas y 0.78 en treinta.
Así que las dos se dividen por una referencia medida sobre los propios datos reales —lo que los registros reales se parecen entre sí— y eso es lo que se puntúa, se colorea y se imprime. El valor bruto y su referencia siguen ahí, en el detail de la métrica y, para el DCR, marcados sobre su histograma.
Gráficos
-
Distance to the closest record — histograma de las distancias, con el percentil informado marcado y, punteada al lado, la misma referencia medida entre los registros reales.
-
Nearest neighbour distance ratio — histograma con el percentil 75 marcado.
Quality
Estructura y relaciones
| Métrica | Qué mide | Óptimo | Bandas |
|---|---|---|---|
| Mean Correlation Score (MCS) | Diferencia absoluta media entre las matrices de correlación real y sintética. | 0 | excellent ≤ 0.2 · fair ≤ 0.4 · poor > 0.4 |
| Cramér's V MSE Score (CVMS) | MSE de la asociación entre pares de columnas categóricas. | 0 | excellent ≤ 0.01 · good ≤ 0.04 · fair ≤ 0.09 · poor ≤ 0.16 · critical > 0.16 |
| MSE Correlation Score (MSCS) | MSE de la razón de correlación entre categóricas y numéricas. | 0 | igual que CVMS |
| Jensen-Shannon Divergence Score (JSDC) | Divergencia de Jensen-Shannon univariante y en combinaciones de 2 y de 3 variables, para detectar relaciones que no se ven columna a columna. | 0 | excellent ≤ 0.1 · good ≤ 0.3 · poor ≤ 0.6 · critical > 0.6 |
Cobertura del espacio de datos
| Métrica | Qué mide | Óptimo | Bandas |
|---|---|---|---|
| Coverage | Si el sintético abarca todo el dato real o se agolpa en sus zonas más densas. | alto | excellent > 0.8 · poor ≤ 0.8 · critical ≤ 0.5 |
| Density | Si la densidad del sintético coincide con la del real. | 1 | excellent 0.5 – 1.5 · poor fuera de ese rango |
| Precision | Proporción de registros sintéticos que caen dentro del soporte del real. | alto | sin banda |
| Recall | Proporción de registros reales cubiertos por el sintético. | alto | sin banda |
| Propensity Score (pMSE) | Si un clasificador consigue separar filas reales de sintéticas. | 0 | excellent ≤ 0.05 · good ≤ 0.2 · poor ≤ 0.5 · critical > 0.5 |
> Precision y Recall van a propósito sin color. Un generador colapsado —que emite pocas filas, todas muy verosímiles— saca una precisión alta, y una copia literal del dato real saca 1.00 en las dos. Un color ahí engañaría más de lo que informa; se leen junto a Coverage y Density, que sí distinguen esos casos.
Fechas
Solo aparecen cuando el conjunto declara columnas de fecha.
| Métrica | Qué mide | Óptimo | Bandas |
|---|---|---|---|
| Weekly MASE | Error de la serie semanal frente a repetir el periodo anterior. Por debajo de 1 el sintético mejora a ese punto de referencia. | 0 | excellent ≤ 0.35 · good ≤ 0.6 · fair ≤ 0.8 · poor ≤ 0.95 · critical > 0.95 |
| Monthly MASE | Lo mismo, mensual. | 0 | igual |
| Day-of-week Profile | Divergencia del perfil por día de la semana. | 0 | excellent ≤ 0.05 · good ≤ 0.12 · fair ≤ 0.25 · poor ≤ 0.4 · critical > 0.4 |
| Month-of-year Profile | Divergencia del perfil por mes. | 0 | igual |
| Date Range Overlap | Solape entre el rango de fechas real y el sintético. | 1 | excellent > 0.95 · fair ≤ 0.95 · poor ≤ 0.85 · critical ≤ 0.5 |
Tablas y gráficos
-
Correlaciones — tres mapas de calor: real, sintético y la diferencia. Una celda oscura en el tercero es una relación que el sintético no reprodujo.
-
Distancia por columna — una fila por variable, peor primero: Kolmogorov-Smirnov para números, variación total para categorías. Las dos van de 0 (idénticas) a 1 (disjuntas). Bandas:
excellent≤ 0.05 ·good≤ 0.10 ·fair≤ 0.20 ·poor≤ 0.35 ·critical> 0.35. Es la tabla que responde qué columna está mal, que es la pregunta de quien tiene que arreglarlo. -
Valores inventados o rangos nunca alcanzados — categorías que no existen en el dato real, números fuera de su rango observado, y diferencias en cuántos nulos tiene cada columna.
-
Distribuciones, real contra sintético — rejilla comparando ambas. El PDF muestra 8 columnas y dice de cuántas; el JSON lleva todas.
-
Perfiles de calendario — series semanales y mensuales, y los perfiles por día de la semana y por mes.
Free Text
Solo aparece cuando el conjunto declara columnas de texto libre.
Estas columnas se miden aparte y se excluyen del bloque de Quality, y la razón es sustancial: una columna de texto libre es casi única por fila, así que como nivel categórico no tiene distribución. Jensen-Shannon sobre ella compara dos conjuntos de valores únicos y Cramér's V no tiene nada que asociar.
Evaluada como categoría produce números con aspecto de medición que no significan nada.
| Columna | Qué se informa |
|---|---|
| Novelty | Proporción de textos sintéticos que no son un texto de entrenamiento reproducido literalmente. |
| Leakage | Proporción de valores sensibles reales que aparecen en algún punto del corpus sintético. Cualquier valor por encima de cero significa que la columna no se puede publicar. |
| Words | Longitud media en palabras. |
| Vocabulary | Riqueza de vocabulario. |
Sobre la novedad hay una advertencia que el propio informe imprime: el sintetizador base no tiene tipo texto — una columna de texto libre le llega como categórica, así que todo valor que emite es un valor que vio entrenando. Con un modelo de lenguaje registrado, esos valores se reescriben y la novedad mide al modelo. Sin él, la novedad es 0 por construcción, y eso es lo que significa el ámbar: no es un fallo del generador, pero la columna no aporta texto nuevo y no debe publicarse como si lo hiciera.
Referential Integrity (multitabla)
Un conjunto de tablas puede puntuar bien una por una y ser inservible junto: pedidos que apuntan a clientes que no existen, o todos los clientes con exactamente tres pedidos cuando los reales van de ninguno a veinte. Ninguna métrica por tabla lo ve, porque los recuentos no son una columna de ninguna de las dos.
| Métrica | Qué mide | Óptimo | Bandas |
|---|---|---|---|
| Orphan Rate | Proporción de filas hijas cuya clave ajena no está en la tabla padre. Se informa la peor relación, no la media. | 0 | excellent = 0 · poor ≤ 0.01 · critical > 0.01 |
| Cardinality Distance | Distancia entre las distribuciones real y sintética de hijos por padre. | 0 | excellent ≤ 0.1 · good ≤ 0.2 · fair ≤ 0.35 · poor ≤ 0.5 · critical > 0.5 |
| Childless Parent Error | Diferencia entre la proporción de padres sin hijos real y sintética. | 0 | excellent ≤ 0.05 · good ≤ 0.1 · fair ≤ 0.2 · poor > 0.2 |
Los huérfanos no son una medida de fidelidad, son de validez: un esquema con huérfanos no carga en la base de datos para la que se hizo. Por eso se informa la peor relación y no el promedio — una relación rota de cuatro promediada es un cuarto de problema, y un cuarto de huérfano sigue siendo una fila que no carga.
Gráficos y tablas
-
Diagrama del esquema — una caja por tabla con su número de filas reales, una flecha por clave ajena apuntando del hijo al padre, y la flecha en rojo cuando esa relación tiene huérfanos.
-
Cada clave ajena, medida por separado — huérfanos, tasa, distancia de cardinalidad, e hijos por padre real y sintético. Medias iguales con una distancia alta dicen que el total está bien y su reparto no.
Utility
Se entrenan modelos en las cuatro combinaciones y se comparan:
| TRTR | Train on Real, Test on Real — el punto de referencia |
| TRTS | Train on Real, Test on Synthetic |
| TSTR | Train on Synthetic, Test on Real — la que dice si el sintético puede sustituir al real |
| TSTS | Train on Synthetic, Test on Synthetic |
Se informan F1, Recall, Precision, Accuracy y AUC en las cuatro. Si no se declara un objetivo, se elige la columna categórica más predecible a partir de las demás — no la más equilibrada: una columna perfectamente equilibrada es muy a menudo un identificador o una etiqueta aleatoria, es decir lo único que nada predice.
Cuándo Utility dice «no aplicable»
Si un modelo entrenado y probado sobre el dato real apenas supera al azar (AUC por debajo de 0.55), ese conjunto no tiene tarea que medir y el score no se calcula.
No es un fallo: sin señal en el dato real, el cociente TSTR/TRTR es el cociente de dos ruidos y oscila decenas de puntos entre ejecuciones sobre los mismos datos. Declinar es la respuesta honesta, y en el informe se lee n/a.
Cómo leer el informe
El resumen ejecutivo
Las cuatro barras de score, sus frases, y —cuando hay hallazgos— un bloque de atención con lo que merece mirarse.
En un conjunto relacional el resumen añade dos cosas que hacen falta para leerlo bien:
-
Una fila por tabla con sus scores, cada uno coloreado en su propia escala: una tabla puede ser fiel y filtrar a la vez, y la fila muestra las dos cosas.
-
Una advertencia de alcance: todas las cifras del resumen son la media entre tablas, métrica a métrica. Ninguna tabla concreta tiene esos valores. Y si algún score promedia menos tablas que el resto —porque en alguna no se pudo medir— el resumen lo dice.
Cómo se configuró la ejecución
Al final del informe: algoritmo, épocas, tamaño de lote, segundos de entrenamiento y si se usó GPU. Sin eso, el documento describe un resultado sin decir de qué configuración salió, y dos ejecuciones con puntuaciones distintas no se pueden explicar.
Los colores
excellent y good en verde, fair en ámbar, poor y critical en rojo, gris cuando no se pudo medir. En el JSON cada métrica lleva su etiqueta de banda en el campo band, así que una interfaz puede colorear sin interpretar una frase.
El JSON
| Clave | Qué contiene |
|---|---|
meta | schema_version, synthesizer, generated_at, library_version, seed, rows, columns, training (algoritmo, épocas, lote, segundos, GPU) y, en multitabla, tables con la lista de tablas. |
scores | Los tres o cuatro. Cada uno con key, label, value, band, range, unit, direction y text en los dos idiomas. |
metrics | Una entrada por métrica: key, group, label, value, band, direction, applicable, description, reason cuando no se pudo medir, y detail cuando conserva el valor bruto (DCR y autenticidad). |
figures | Histogramas, matrices de correlación, series de calendario, distribuciones por columna y el diagrama del esquema. Cada una con id, kind, group, title, caption y data. |
tables | per_table, utility_models, column_shapes, domain_coverage, referential_relationships y text_columns, según lo que aplique. Cada una con columns, rows, bands y caption. |
findings | Lo que merece atención, con severity, source y text. |
texts | Un bloque por columna de texto libre, cualificado por tabla en multitabla. |
referential | (solo multitabla) El detalle de cada clave ajena medida. |
Los tipos de figura son numeric, categorical, histogram y schema.
Las figuras llevan los números —los tramos de un histograma, las celdas de una matriz, los nodos y aristas de un esquema— y nunca un PNG. Una imagen en base64 permite mostrar una estampa del gráfico y nada más: sin tooltip, sin zoom, sin ordenar, sin adaptarse a modo oscuro. Con las series, la interfaz dibuja con su propia librería y el PDF rasteriza los mismos números, así que los dos no pueden divergir. También hace el JSON comparable: dos ejecuciones se pueden contrastar campo a campo, algo que dos PNG nunca permiten.
En un conjunto relacional, las figuras y los bloques de texto van cualificados por tabla (clientes__dist_saldo, notas.descripcion), porque cuatro tablas con una columna created_at son cuatro columnas distintas y no una repetida cuatro veces.